OpenAI Realtime API 端到端实现逆向分析
从客户端音频、实时传输、会话控制到语音模型与工具执行
这是一份 clean-room 式系统还原:依据 OpenAI 公开文档、API 事件、标准协议和可观察产品行为,分析“如果自己实现一套类 GPT Live 应用,系统应如何设计”。它不破解 OpenAI 服务,不声称知道未公开的模型拓扑、训练数据、服务端代码或调度算法。
文档中的结论分为三类:公开事实来自官方契约;工程推断是满足已公开行为所必需或高度合理的机制;设计建议是我们自建产品时的取舍,不等于 OpenAI 内部实现。
证据快照:2026-09-01。模型、价格、配额、API 字段和 SDK 实现可能变化,实施时应重新核对 OpenAI Docs 与固定版本源码。
阅读前先分清
| 名词 | 在本文中的含义 |
|---|---|
| Realtime Session | 当前实时对话的短生命周期状态对象,不是长期业务任务的事实源。 |
| WebRTC / WebSocket / SIP | 分别偏向终端实时媒体、已有服务器媒体管线与电话入口的传输边界。 |
| sideband | 自有后端连接同一 Session 的控制通道,用于指令更新、工具处理和监督,不转发全部媒体。 |
| Capability Gateway | 业务侧的授权、确认、幂等、审计和真实 API 执行边界。 |
| 可听历史 | 用户实际听到的位置;打断后模型上下文必须向此位置对齐。 |
如果只读一页
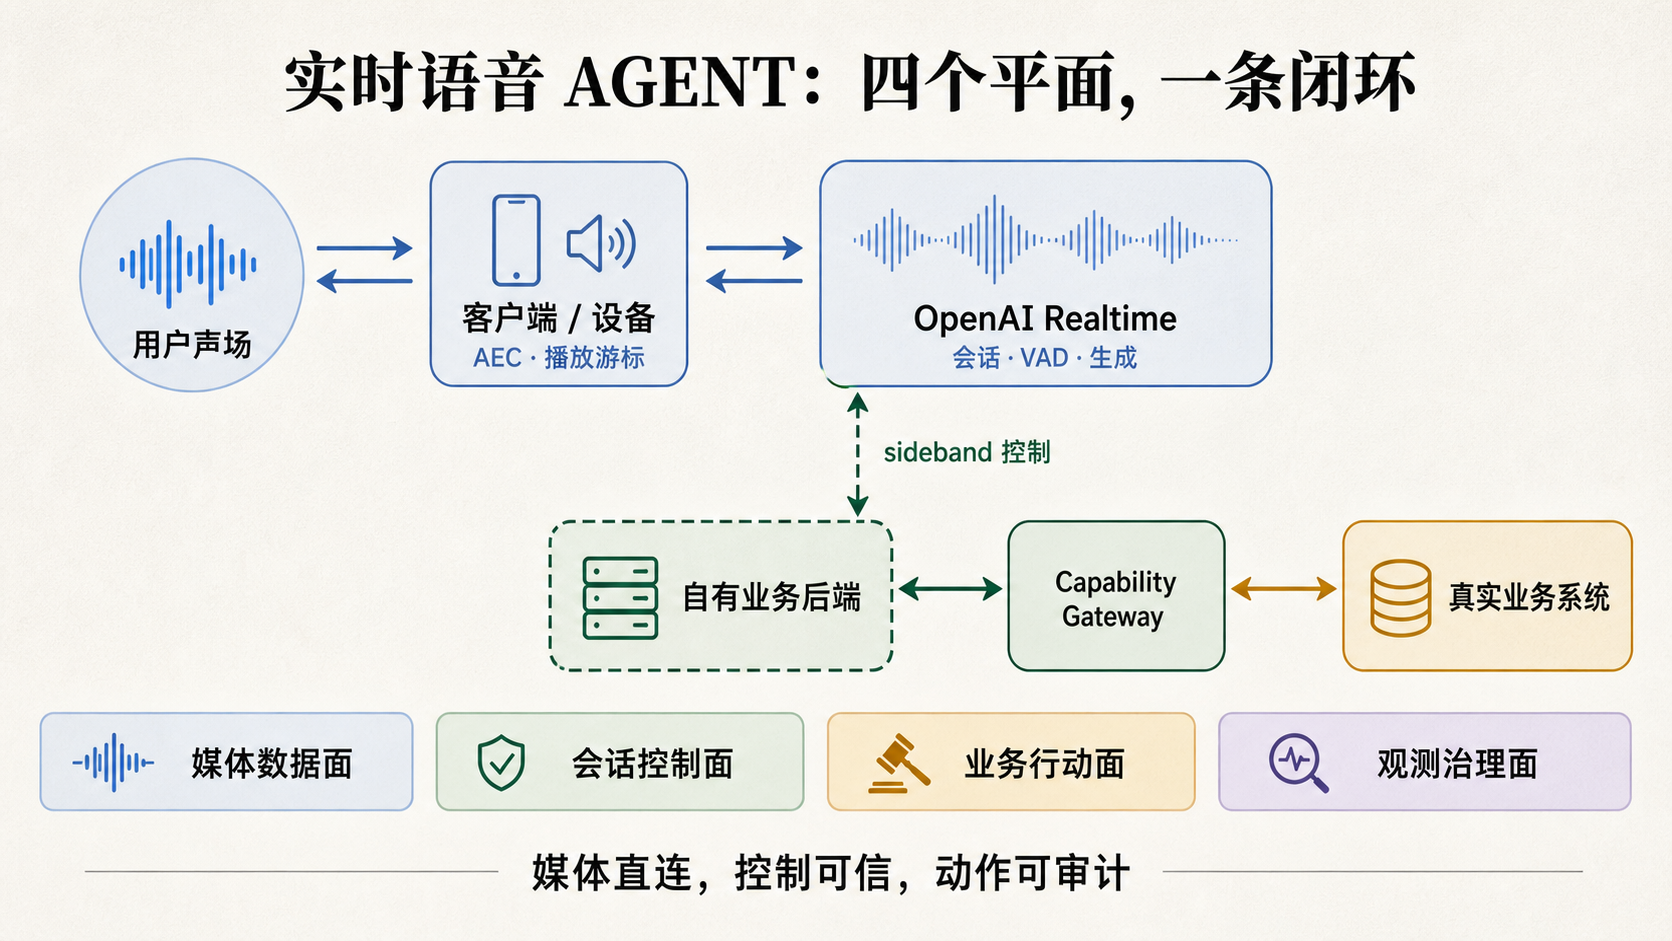
OpenAI Realtime API 不是一个完整语音助手,而是一台通过持续连接暴露的实时语音智能引擎。一款类 GPT Live 产品至少还有客户端音频、实时传输、业务后端、工具执行、持久状态、观测和安全治理。
最接近 GPT Live 体验的自建架构不是“客户端把音频传给后端,后端再转给模型”这一条粗管道,而是四个并行平面:
- 媒体数据面:麦克风 → AEC/降噪/增益 → WebRTC → Realtime 模型 → WebRTC → 扬声器。
- 会话控制面:VAD、轮次、打断、取消、播放游标、对话截断、Session 配置和错误恢复。
- 业务行动面:Function/MCP → 身份和权限 → 幂等与确认 → 真实业务 API → 结果回传。
- 观测治理面:Trace、延迟、音频质量、成本、隐私、审计、限流和会话轮换。
浏览器和移动端的推荐拓扑是:
- 客户端使用短期凭据直接通过 WebRTC 连接 OpenAI,避免让自有后端转发全部媒体;
- 自有后端通过同一 Realtime Session 的 sideband WebSocket 监控会话、更新指令、处理工具调用;
- 真实副作用进入自有 Capability Gateway,不把模型判断等同于权限;
- 需要数十秒到数小时的任务交给后台 Job/Agent,Realtime 会话只负责即时对话、进度和结果播报。
最难的功能不是“让模型说话”,而是自然打断。一次正确打断同时需要:
- 客户端在播音时继续收音,并通过 AEC 避免助手听到自己;
- VAD 判断用户开始插话;
- 立刻取消生成并清空播放链路;
- 丢弃已经到达但尚未播放的旧音频;
- 把模型对话历史截断到用户实际听到的位置;
- 用
response_id/item_id等 generation fence 丢弃取消后的迟到事件。
因此,产品层面的“端到端”不是“所有东西都在一个模型里”,而是:
从真实声场到真实声场,从用户意图到真实业务结果,整条链路都在一个可打断、可同步、可观测、可恢复的控制闭环里。
一、这里的“端到端”到底指什么
1.1 不是一个含糊的“音频进、音频出”
本报告把端到端起点定义为用户产生声压,终点定义为用户听到声音或现实系统完成动作:
用户声场
  → 麦克风与 ADC
  → 客户端音频前处理
  → 编码、分帧与实时传输
  → OpenAI Realtime Session
  → 实时语音模型与工具决策
  → 音频或工具事件流
  → 解码、抖动缓冲与扬声器播放
  → 用户听到声音

或:

  → 工具调用
  → 自有权限与业务系统
  → 真实动作
  → 结构化结果回到模型
  → 模型向用户确认实际结果
这一定义同时包含五种“连续性”:
| 连续性 | 真正要连续的对象 | 断裂后的表现 |
|---|---|---|
| 音频连续性 | 采集、编码、网络、解码、播放时钟 | 卡顿、爆音、音高异常、越积越慢 |
| 轮次连续性 | 谁在说、何时说完、何时插话 | 抢话、长时间沉默、无法打断 |
| 语义连续性 | 模型记忆与用户实际听到的内容一致 | 模型引用用户从未听到的内容 |
| 行动连续性 | 工具意图、授权、执行、结果一一对应 | 重复下单、假成功、错用户操作 |
| 产品连续性 | Session 之外的身份、任务、记忆和审计 | 断线后失忆,长任务无处恢复 |
1.2 “端到端模型”与“端到端产品”不是同一件事
OpenAI 官方把语音 Agent 分为两条架构:speech-to-speech live session,以及显式串联 STT → text agent → TTS 的 chained pipeline。前者适合自然、低延迟、barge-in 和实时工具使用;后者适合可预测流程、稳定转写和阶段间确定性逻辑。Voice agents
即使采用原生 speech-to-speech 模型,产品仍是分布式系统:
- 麦克风、回声消除和播放在设备上;
- 媒体协议在 WebRTC/WebSocket/SIP;
- Realtime Session 在 OpenAI;
- 权限、业务真相和长期记忆在自有后端;
- 真实动作发生在外部业务系统或 IoT 设备。
所以更准确的说法是:
模型可以是音频端到端的,产品必须是混合分层的。
二、证据边界:我们能还原什么,不能还原什么
2.1 OpenAI 已公开的事实
截至证据快照,OpenAI Docs 明确公开了:
- Realtime 会话是有状态的
Session + Conversation + Items + Responses;客户端发送事件并接收服务端事件。Realtime conversations - 客户端/移动端推荐 WebRTC,已有服务端媒体管线推荐 WebSocket,电话场景使用 SIP。Realtime overview
- WebRTC 使用媒体轨道传音频、DataChannel 传事件;客户端可通过开发者后端签发的短期凭据建立连接。Realtime with WebRTC
- WebSocket 是更底层的 server-to-server 接口,调用方负责发送和处理 Base64 音频块。Realtime with WebSocket
- VAD 支持基于静音切分的
server_vad和基于语义完成度的semantic_vad,并发出speech_started/speech_stopped事件。Realtime VAD - Realtime 支持 Function Calling;Function 由开发者应用执行,MCP 工具可由 Realtime API 连接和执行。Realtime with tools
- WebRTC/SIP 可用 sideband 控制通道,让客户端和应用服务器同时连接同一 Session。Server-side controls
- 当前
gpt-realtime-2.1是音频/文本输入输出、支持推理和工具使用的 Realtime 模型;更高 reasoning effort 可能提高延迟和输出 token。GPT-Realtime-2.1 - OpenAI Agents SDK for Python 开源了开发者侧的 Realtime 应用运行时:
RealtimeRunner、RealtimeSession、WebSocketRealtimeModel、工具/审批/guardrail/handoff,以及独立的 STT → Agent workflow → TTSVoicePipeline。它运行在开发者服务器,不是 OpenAI Realtime 服务或模型源码。Realtime Agents quickstart · Voice pipeline quickstart · 固定源码89c02c8
2.2 公开资料无法证明的内部实现
以下问题不能从公开 API 反推出确定答案:
- 内部是否由独立 ASR、语言模型、声学模型和 vocoder 组成;
- 音频 token 的编码方式、帧率、码本、对齐和训练目标;
- VAD 是独立模型、共享前端还是与主模型联合训练;
- 推理、工具选择和语音生成是否由同一个权重路径完成;
- 多租户 Session 如何调度到 GPU、如何迁移、如何做 KV cache;
- 安全模型、内容过滤和声纹策略位于链路哪一层;
- ChatGPT 产品中的 GPT Live 如何与 Codex 或其他后台 Agent 路由。
报告后文出现的“音频编码器”“增量上下文缓存”“输出音频解码器”等模块,是为了说明如果我们训练或自托管同类模型,需要哪些能力,不是对 OpenAI 内部代码的断言。
三、推荐总体架构:直连媒体 + 后端 sideband + 能力网关
这个拓扑有三个关键收益:
- 媒体不绕行自有后端:降低一次额外转发、编码和带宽成本,也减少后端媒体扩容压力。
- 业务逻辑不下放客户端:Prompt、工具、凭据、权限和审计仍在服务端。
- 实时会话与长任务解耦:60 分钟级 Live Session 不是长期业务状态的唯一容器;后台 Job 可独立恢复和重试。
OpenAI 官方 sideband 设计明确允许同一个 WebRTC/SIP Session 同时拥有客户端连接和服务器连接;服务端可监听事件、更新指令、响应工具调用。Server-side controls
四、职责矩阵:OpenAI 实现什么,我们还必须实现什么
| 能力 | 客户端/设备 | 自有后端 | OpenAI Realtime | 真实业务系统 |
|---|---|---|---|---|
| 麦克风权限与采集 | 主责 | 不负责 | 不负责 | 不负责 |
| AEC、降噪、AGC、波束形成 | 主责 | 可提供配置/诊断 | 可改善模型侧噪声鲁棒性,但不能替代设备 AEC | 不负责 |
| 编解码、抖动、播放 | WebRTC 时大部分由客户端栈承担;WebSocket 时完全主责 | 媒体网关方案下承担 | 终止传输并流式生成音频 | 不负责 |
| 短期认证 | 获取短期凭据 | 签发、绑定用户和设备 | 验证凭据 | 不负责 |
| 会话历史 | 展示和轻量镜像 | 持久化业务投影 | 维护当前 Realtime Conversation | 保存业务事实,不保存模型幻觉 |
| VAD 与轮次 | 本地快速提示、PTT、播放联动 | 策略与指标 | server_vad / semantic_vad 和轮次事件 | 不负责 |
| 打断 | 停播、flush、本地游标 | 竞态治理与观测 | 取消响应;WebRTC/SIP 自动截断未播放部分 | 取消可取消的外部任务 |
| 音频理解与生成 | 不负责语义模型 | 选择模型、Prompt 和策略 | 主责 | 不负责 |
| 工具选择 | 只发送用户意图 | 定义工具和政策 | 决定是否调用、生成参数 | 不负责 |
| 工具执行 | 只做低风险设备本地动作 | Function、Capability Gateway、HITL 主责 | MCP/Connector 可代执行 | 真实动作和真相源 |
| 长期记忆 | 本地偏好缓存可选 | 主责,按权限检索和写入 | 当前 Session 上下文,不应作为唯一长期记忆 | 保存业务记录 |
| 断线、重连与恢复 | 网络状态和重新建连 | Session 轮换、摘要恢复、幂等 | 提供连接和事件,不替代产品恢复协议 | 保证动作幂等 |
| 可观测与合规 | QoE、设备指标、用户同意 | Trace、成本、审计、保留策略 | API usage/tracing 能力 | 业务审计 |
一句话划分:
OpenAI 负责“实时听懂、组织回答、生成声音和提出工具调用”;我们的系统负责“正确采集和播放、可信身份、真实行动、长期状态,以及失败后仍然说得清发生了什么”。
五、客户端音频:自然体验的一半在模型之外
5.1 采集链路
浏览器最小采集接口可以只是 getUserMedia({ audio: true }),但量产实现应显式处理:
- 用户授权、权限撤销和系统隐私指示;
- 输入设备选择、耳机插拔、蓝牙 profile 切换;
- 单声道语音、采样率、位深和重采样;
- 10–20 ms 级短帧处理与稳定时间戳;
- 音频焦点、来电/闹钟/导航抢占;
- 前后台切换、屏幕锁定、节能和热管理;
- 设备变化后的 AEC 重新收敛。
W3C Media Capture 标准把 echoCancellation、noiseSuppression、autoGainControl、latency、sampleRate 和 channelCount 都定义为可约束属性,但浏览器最终实现和设备能力可能不同;“请求开启”不等于声学质量已经合格。Media Capture and Streams
推荐浏览器基线:
const stream = await navigator.mediaDevices.getUserMedia({
  audio: {
    echoCancellation: true,
    noiseSuppression: true,
    autoGainControl: true,
    channelCount: 1,
  },
});
代码只是请求约束。上线前仍要用真实设备检查 track.getSettings()、录音波形和双讲表现。
5.2 为什么 AEC 是打断能力的前提
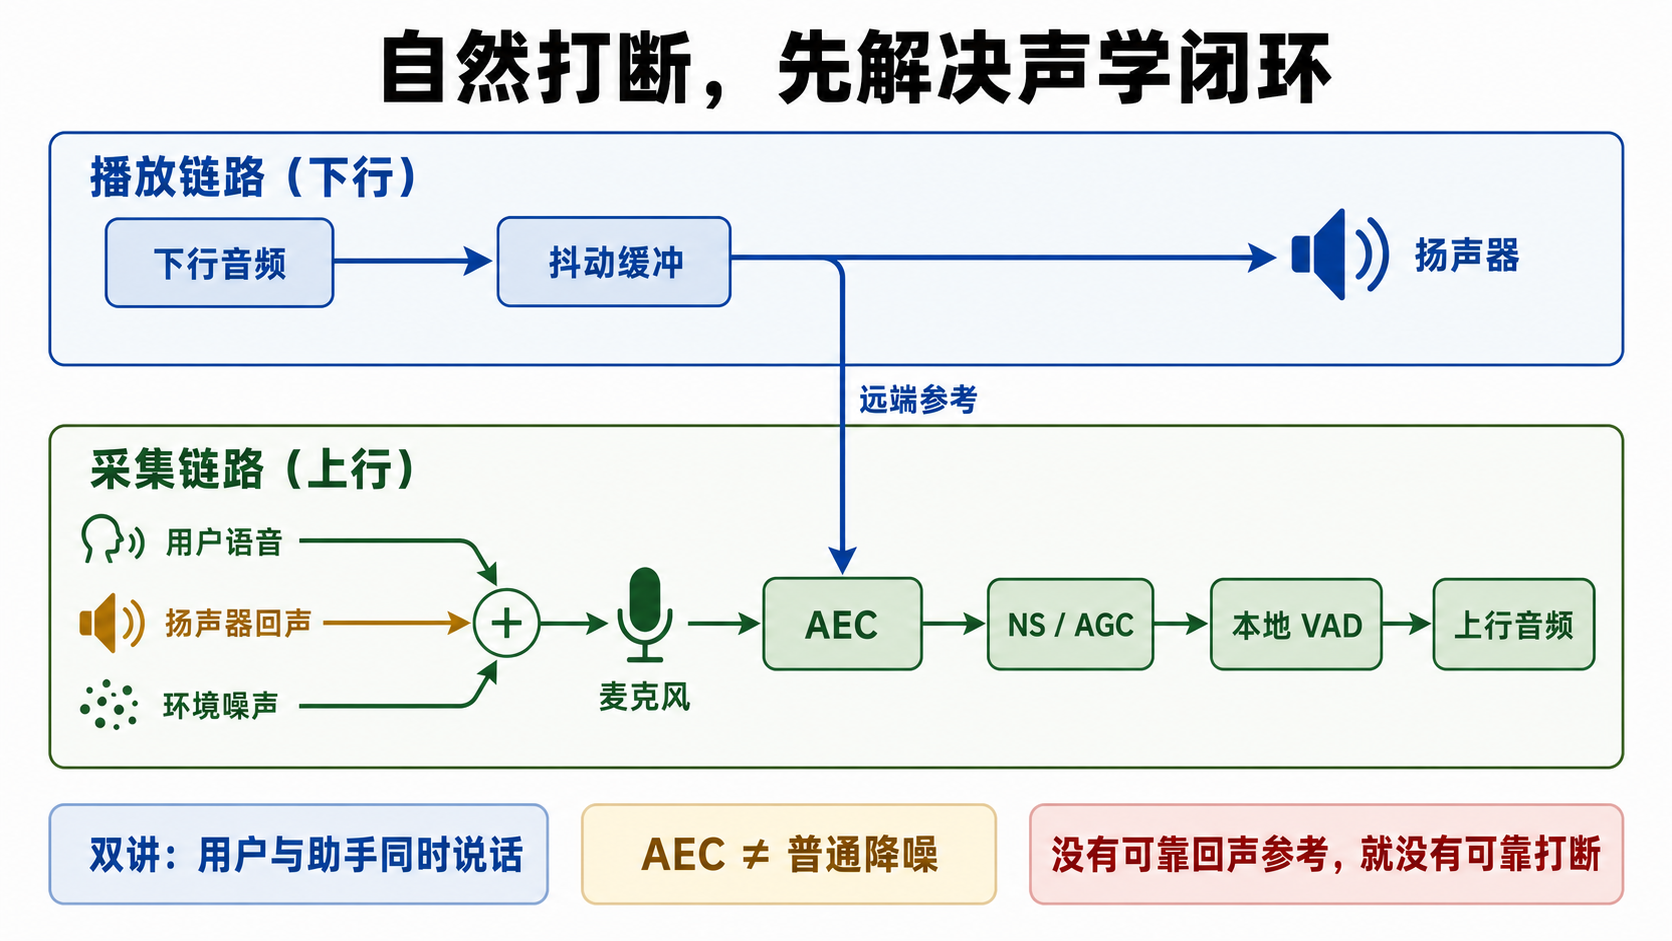
当助手从扬声器播报时,麦克风会同时收到:
mic = 用户近端语音 + 扬声器远端回声 + 环境噪声 + 房间混响若没有 Acoustic Echo Cancellation,服务端 VAD 很可能把助手自己的声音识别为用户插话。正确的 AEC 需要:
- 一路麦克风信号;
- 一路“远端参考”,最好接近真正送入扬声器的 PCM;
- 对采集与播放时钟差、系统缓冲和声学路径做延迟估计;
- 在线估计线性回声路径,并处理扬声器失真等非线性残留;
- 在 double-talk——用户和助手同时说话——时保护用户语音,而不是把两者一起消掉。
浏览器通常复用 WebRTC Audio Processing;原生移动端应优先使用系统 Voice Communication/Voice Processing 音频模式;树莓派或自研硬件需要 libwebrtc APM、硬件 DSP 或等价方案。仅使用模型侧降噪不能替代 AEC,因为模型看不到与扬声器严格同步的远端参考。
5.3 NS、AGC 与波束形成
- Noise Suppression 去除稳态风扇、空调和部分非稳态噪声;过强会损伤辅音、音乐和情绪线索。
- Automatic Gain Control 让远近说话音量更稳定;过强会在静音时放大底噪。
- Beamforming 在麦克风阵列上增强目标方向,适合远场音箱、AI 眼镜和会议设备。
- High-pass / DC removal / limiter 解决低频机械噪声、直流偏置和削波保护。
优先级不是“算法越多越好”,而是:不过载、低噪、回声可控、用户语音自然、延迟稳定。面向 speech-to-speech 模型时尤其要避免过度处理抹掉语气和韵律。
5.4 本地 VAD 与服务端 VAD 如何协作
服务端 VAD 决定 Realtime Conversation 的正式轮次;本地 VAD 更适合做低延迟 UI 和 provisional interrupt:
本地高置信检测到近端语音
  → 立即把播放增益拉到 0 或暂停(可撤销)
  → 等待服务端 speech_started
  → 确认后永久 flush + cancel/truncate

如果服务端未确认
  → 恢复播放或提示误触
这是设计建议,不是 OpenAI 的强制流程。它用少量误触风险换取更快的物理“闭嘴”时间,适合对 barge-in 极敏感的产品。第一版可先只依赖服务端 VAD,收集数据后再引入本地 provisional VAD。
5.5 播放链路必须有真实游标
不要把“从网络收到了多少音频”当作“用户听到了多少音频”。播放系统至少维护:
received_audio_ms   已收到
decoded_audio_ms    已解码
queued_audio_ms     已进入播放队列
rendered_audio_ms   声卡已经消费
audible_audio_ms    估计真正发声
WebSocket 截断应尽量使用 rendered_audio_ms 或可信近似,而不是 received_audio_ms。播放器还需要:
- 按
response_id隔离播放队列; - 取消后丢弃旧 generation 的迟到音频;
- 使用有上限的 jitter/ring buffer,禁止无限积压;
flush(response_id)原子清空解码器、队列和音频 sink;- 耳机/扬声器切换时重建播放时钟和 AEC 参考。
六、传输层:WebRTC、WebSocket、SIP 是三种不同责任模型
6.1 WebRTC:浏览器和移动端默认选择
OpenAI 推荐浏览器和移动客户端使用 WebRTC。典型流程是:
- 客户端向自有后端认证;
- 后端使用长期 API Key 创建短期 client secret;
- 客户端创建
RTCPeerConnection; - 麦克风以 MediaStream Track 加入连接;
- 客户端创建
oai-eventsDataChannel; - 通过 SDP 与 OpenAI 建立 Realtime call;
- 远端音频轨道直接进入播放器,事件走 DataChannel。Realtime with WebRTC
WebRTC 协议栈通常提供:
- RTP/SRTP 媒体与 DTLS 密钥协商;
- ICE 网络路径发现和 NAT 穿透;
- Opus 等实时音频编解码;
- packet loss concealment、jitter buffer、拥塞和带宽适应;
- SCTP/DTLS DataChannel 传控制事件。
这些是 WebRTC 标准能力,不表示 OpenAI 文档承诺某个固定 codec 或内部网络拓扑。参考 WebRTC 1.0、WebRTC transports RFC 8835 和 Opus RTP RFC 7587。
产品判断:只要设备平台有成熟 WebRTC,优先直连。不要为了“后端统一”把浏览器音频先绕到业务服务器,再二次转发给 OpenAI。
6.2 WebSocket:服务端媒体管线与嵌入式网关
WebSocket 更适合:
- 电话/会议媒体已经进入自有服务器;
- 需要自定义音频前处理或录制;
- 嵌入式设备没有成熟 WebRTC,但能稳定上传 PCM;
- 必须从私有网络统一出站;
- 需要把 OpenAI 隔离在自有媒体网关之后。
代价是调用方承担更多责任:
- 音频分帧、Base64、发送节奏和 input buffer;
- 输出音频解码、背压和播放时钟;
- 断线后的本地缓冲取舍;
- 打断时停止播放并发送
conversation.item.truncate; - 迟到消息和重复事件去重。
OpenAI 将 WebSocket 描述为 Realtime 最低层的接口之一,调用方负责发送和处理 Base64 音频块。Realtime with WebSocket
6.3 SIP:电话 Agent
SIP 适合 PSTN/VoIP 电话。SIP trunk provider 把电话号码接入 OpenAI SIP endpoint;OpenAI 通过 realtime.call.incoming webhook 通知应用服务器,服务器再接受、拒绝、挂断或通过控制连接操作通话。Realtime with SIP
电话链路还要额外处理:
- 8 kHz 窄带与编解码质量;
- DTMF、转接、保持、录音提示;
- 呼叫身份、地区法规和拒接策略;
- webhook 幂等与重复投递;
- 运营商级超时、忙音和异常挂机。
6.4 三种传输如何选
| 场景 | 首选 | 原因 | 主要自担责任 |
|---|---|---|---|
| Web / App 直接语音 | WebRTC | 最低媒体工程成本,天然双向音频 | 权限、AEC 质量、UI、设备切换 |
| 树莓派带浏览器/PWA | WebRTC | 可复用浏览器音频与协议栈 | 硬件 AEC、音频设备稳定性 |
| 原生嵌入式、私有媒体网关 | WebSocket | 易与 C++/Rust/GStreamer/自有 PCM 管线结合 | 编解码、缓冲、播放游标、截断 |
| 已有服务器电话媒体 | WebSocket 或 SIP | 取决于是否保留自有 telephony stack | 电话状态、录音、合规、媒体桥接 |
| 直接电话 Agent | SIP | OpenAI 直接接收呼叫 | webhook、业务控制、转接和审计 |
七、Realtime Session:把它看成一个短生命周期 Session Actor
7.1 对象模型
公开协议可以抽象为:
RealtimeSession
├── SessionConfig
│   ├── model / voice / instructions
│   ├── input and output audio
│   ├── turn_detection
│   ├── tools / tool_choice
│   └── truncation / tracing / limits
├── Conversation
│   ├── user Item
│   ├── assistant Item
│   ├── function_call Item
│   └── function_call_output Item
├── InputAudioBuffer
└── Response[n]
    ├── response_id
    ├── output Item[n]
    ├── audio/text delta
    └── completed / cancelled / failed
官方说明 Realtime Session 由 Session、Conversation 和 Responses 组成;客户端通过事件改变状态,通过服务端事件观察状态。Realtime conversations
7.2 正常语音轮次
7.3 我们自己的状态不能只靠 Conversation
Realtime Conversation 是模型当前会话上下文,不应成为产品唯一真相源。自有后端至少保存:
ProductConversation
├── user_id / tenant_id / device_id
├── current_realtime_session_id / call_id
├── semantic summary and memory refs
├── active response / turn state
├── pending confirmation
├── tool call ledger
├── background job refs
└── privacy / retention policy
理由:
- 官方文档给出的 Realtime Session 最大持续时间是 60 分钟;产品必须能轮换 Session。Realtime conversations
- 用户可能从手机切到电脑或硬件;产品身份不能等于一次网络连接。
- 工具调用可能已经改变真实世界;Conversation 删除不能撤销业务动作。
- 长任务需要独立重试、取消和投递,不应依赖一条持续音频连接。
八、打断的完整实现:声学、播放和语义三重同步
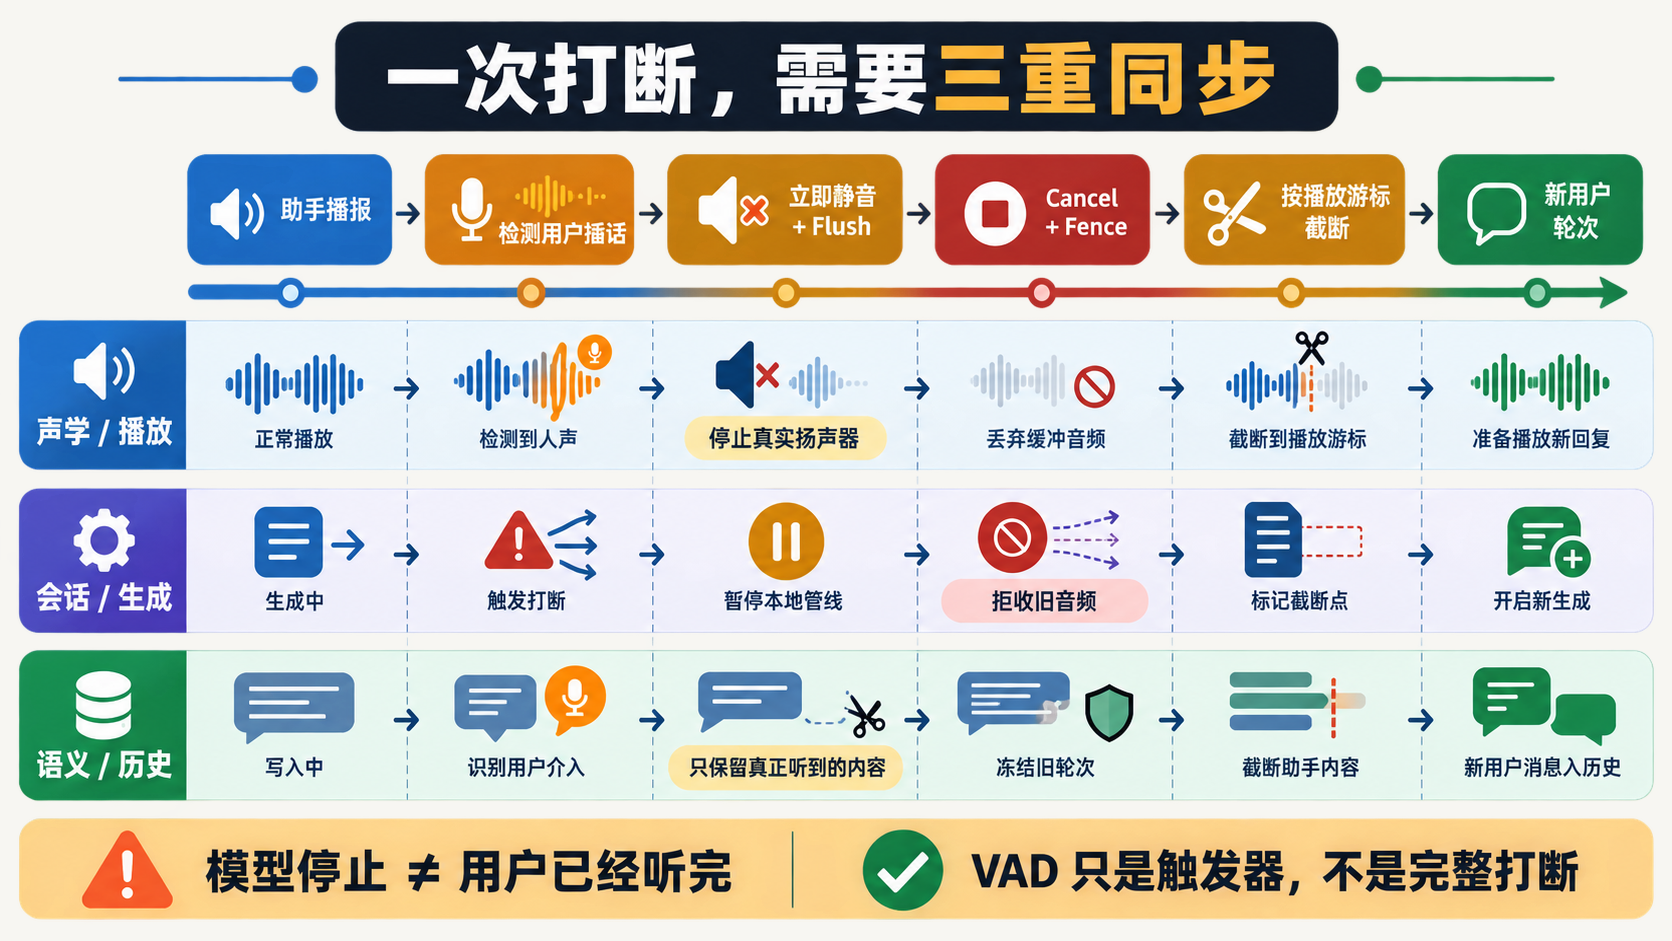
8.1 官方公开流程
当 VAD 开启时,Realtime 可检测用户讲话、取消正在生成的响应并开始新轮次。关键差异是:
- WebRTC / SIP:OpenAI 服务端管理 output audio buffer,知道播放进度,可在用户插话时自动截断未播放音频。
- WebSocket:客户端管理播放,必须立即停播、记录已播放时长,并发送
conversation.item.truncate。Interruption and truncation
WebSocket 例子中,conversation.item.truncate 用 item_id、content_index 和 audio_end_ms 表示用户实际听到的位置。官方也说明音频和 transcript 无法被模型精确逐字对齐;截断会删除未播放部分的 transcript,而不是返回一份精确裁切后的文字稿。
8.2 产品级打断状态机
response_done 不能直接等于“用户已经听完”。只有音频 sink 排空、未发生取消且 generation 仍然有效,才能把本轮标记为 audible_completed。
8.3 竞态:取消后旧音频仍可能到达
推荐客户端维护 generation fence:
type PlaybackGeneration = {
  responseId: string;
  itemId: string;
  state: "active" | "cancelled" | "completed";
  renderedMs: number;
};

function onAudioDelta(event) {
  const generation = generations.get(event.response_id);
  if (!generation || generation.state !== "active") return;
  player.enqueue(event.response_id, event.delta);
}

function interrupt(responseId) {
  generations.get(responseId).state = "cancelled";
  player.flush(responseId);
  transport.cancelResponse(responseId);
}
实际协议事件未必都显式携带完全相同的字段;实现时应以当前 API schema 为准。这里的核心原则是:任何旧 generation 的迟到数据都不能重新让扬声器开口。
8.4 打断验收不是“我试了一次可以”
至少测试:
| 测试 | 预期 |
|---|---|
| 助手大音量播报,用户不说话 | 不应自我打断 |
| 用户在助手第一个字时插话 | 快速停播,新轮次不丢首字 |
| 用户在第 8 秒插话 | 历史只保留实际已播内容 |
| 用户只发出咳嗽、键盘声、碰撞声 | 不应频繁永久打断 |
| 双讲,用户小声、扬声器大声 | AEC 后用户仍可被检测 |
| cancel 后网络迟到 500 ms 音频 | 扬声器保持安静 |
| WebSocket 播放队列积压 3 秒 | audio_end_ms 依据真实 render,不依据 receive |
| 连续两次快速插话 | 第二次不被第一轮残留状态污染 |
建议核心指标:barge_in_to_silence_ms、false barge-in rate、missed barge-in rate、self-interruption rate、truncation drift ms。
九、轮次检测:VAD 不是一个布尔开关
9.1 server_vad
server_vad 根据声学活动和静音间隔切分。常见参数包括 threshold、prefix padding 和 silence duration。优点是可预测、延迟低;缺点是:
- 思考停顿容易被误判为说完;
- 背景说话可能被当作用户;
- 语言、说话速度和口吃差异大;
- 参数越激进,响应越快但越容易抢话。
9.2 semantic_vad
semantic_vad 根据用户话语是否语义完整决定轮次结束,目标是减少用户还没说完就被切断。它可通过 eagerness 调整抢答倾向。Realtime VAD
它仍然不能解决:
- 电视、旁人和用户本人谁在说;
- 用户是否在对助手说话;
- 高风险指令是否来自授权用户;
- 物理回声是否已被消除。
因此产品层还需要 wake word、PTT、面向设备的 addressability 判断、近场/远场信号和交互状态。
9.3 推荐策略
| 产品场景 | 推荐 |
|---|---|
| 自由对话、教练、陪伴 | semantic_vad,中低 eagerness,重视不抢话 |
| 快问快答、导航、操作指令 | server_vad 或较高 eagerness,重视速度 |
| 工业噪声、开放办公室 | PTT / wake word + 服务端 VAD |
| 高风险动作 | VAD 只负责轮次;动作前仍需参数复述与确认 |
| AI 音箱/树莓派外放 | 本地 AEC + local provisional VAD + server VAD 双层 |
十、大模型层:公开能力与自建实现路径
10.1 把 OpenAI 模型当作什么
对应用架构而言,最可靠的抽象不是“ASR + LLM + TTS 的黑盒”,而是一个具有以下接口的 Session Actor:
inputs:
  live audio + text + optional image + tool results + instructions

state:
  ordered conversation items + current response + turn configuration

outputs:
  live audio + transcript/text + tool calls + lifecycle events

controls:
  update session + create/cancel response + truncate item + tools + VAD
当前 OpenAI 模型页说明 gpt-realtime-2.1 支持 speech-to-speech、reasoning effort、instruction following 和 tool use,并改善噪声、静音、字母数字识别和打断行为。GPT-Realtime-2.1
10.2 如果我们连模型也要自己实现
有三条现实路线:
| 路线 | 模块 | 优点 | 难点 |
|---|---|---|---|
| 串联式 | streaming ASR → text LLM → streaming TTS | 可观测、可替换、转写稳定、审计容易 | 累积延迟,语气信息损失,打断跨三段同步 |
| 原生音频端到端 | audio tokenizer/encoder → multimodal transformer → streaming audio decoder | 自然韵律、低首音延迟、可直接建模情绪和重叠语音 | 数据与训练成本极高,工具/文本可控性和调试更难 |
| 混合式 | 原生音频理解 → 文本/结构化推理与工具 → 独立 TTS | 兼顾语音理解和品牌音色/固定话术 | 需要跨表示对齐,仍有 TTS 延迟 |
一个可训练的原生系统至少需要这些能力:
音频前端 / tokenizer
  → 流式因果编码与增量缓存
  → 文本、音频、工具的统一上下文表示
  → 轮次与说话者/可寻址性建模
  → reasoning / tool head
  → 流式 acoustic token decoder
  → neural codec / vocoder
  → 安全、身份和输出水印等产品层控制
这只是自建蓝图。公开资料不足以证明 OpenAI 内部采用相同模块边界。
10.3 对绝大多数团队的正确选择
不要从训练 native audio model 起步。先使用 Realtime API 验证:
- 目标场景的音频质量和口音覆盖;
- 首音延迟、轮次体验和打断;
- 工具调用可靠性;
- 成本与会话长度;
- 隐私、地域和合规边界。
只有当模型成本、数据主权、品牌音色或垂直语音能力成为已证实瓶颈,再替换模型层。客户端、控制面、Capability Gateway 和观测模型应保持独立,避免与单一模型耦合。
十一、工具调用:模型可以决定“想做什么”,不能自行获得权限
11.1 Function 与 MCP 的责任不同
- Function tool:模型产生函数名和参数;开发者应用执行代码;再用相同
call_id回传function_call_output。 - MCP tool:Realtime API 可以连接远程 MCP server 或 OpenAI-managed connector 并执行;配置可包含
allowed_tools和require_approval。Realtime with tools
即使 MCP 由 OpenAI 发起请求,资源所有者、授权范围和业务审计仍是我们的责任。
11.2 Capability Gateway
任何写操作都应经过确定性网关:
ToolIntent
  → 解析 user / tenant / device / conversation
  → schema validation
  → policy check
  → exact identifier read-back
  → optional human confirmation
  → idempotency reservation
  → real API call
  → result verification
  → audit record
  → structured FunctionResult
推荐结果结构:
{
  "status": "succeeded",
  "action": "set_light_brightness",
  "resource_id": "living-room-main",
  "effective_value": 30,
  "idempotency_key": "turn_...:call_...",
  "audit_id": "audit_..."
}
模型只能在 status == succeeded 后说“已经完成”。OpenAI 的 Realtime prompting guide 也建议写操作先说明后果并确认,工具失败后不得编造成功。Using realtime models
11.3 长任务怎样接入 GPT Live 式前台
Realtime Session 适合即时交互,不应被迫持有所有长任务。推荐把长任务包装为工具:
start_job(spec) -> { job_id, accepted, expected_update }
get_job(job_id) -> { state, progress, summary }
cancel_job(job_id) -> { state }
Realtime 前台负责:
- 澄清任务;
- 创建 Job;
- 立即告诉用户“已经开始”;
- 保持听说和打断能力;
- 在 Job 返回里程碑或结果时用自然语言播报。
后台 Agent 负责:
- 多步工具操作;
- checkpoint、重试和恢复;
- 产物、证据和审批;
- 用户离线后的持续运行。
这是根据产品职责做出的设计建议,不代表 ChatGPT Live 内部的公开实现。
十二、后端应该拆成哪些深模块
12.1 Session Credential Service
职责:
- 验证用户、租户和设备;
- 使用长期 OpenAI API Key 创建短期 client secret;
- 绑定允许的模型、工具、速率和产品策略;
- 永不把长期 API Key 交给客户端。
12.2 Session Broker
维护:
product_conversation_id
↔ realtime_session_id / call_id
↔ user_id / tenant_id / device_id
↔ active_response_id
↔ sideband_connection_owner
它不代理全部音频,而是负责建立、轮换、关闭和恢复 Session。
12.3 Sideband Controller
职责:
- 监听同一 Realtime Session 的事件;
- 动态更新 instructions 和 tools;
- 处理 function calls;
- 同步业务状态和可观测字段;
- 在策略变化、权限撤销或用户退出时终止会话。
12.4 Turn Coordinator
统一这些状态:
listening
user_speaking
thinking
assistant_speaking
interrupted
tool_waiting
failed
它要区分 model response done、network audio received、player drained 和 user heard,并处理 cancel/truncate 竞态。
12.5 Capability Gateway
主责身份、策略、确认、幂等、审计和真实业务调用。它是模型与现实副作用之间的最终安全边界。
12.6 Memory Service
把状态分成:
- Realtime Session 内的临时对话;
- 当前产品 Conversation 的摘要和未决事项;
- 用户明确授权的长期偏好;
- 业务系统中的权威事实。
每次新 Session 只注入完成当前任务所需的最小信息,不重放全部录音和 transcript。
12.7 Observability Pipeline
采集客户端 QoE、Realtime 事件、工具调用、成本和用户反馈,形成跨层 Trace。
十三、延迟工程:优化的是临界路径,不是平均数
13.1 首音延迟公式
T_first_audio =
    T_capture_frame
  + T_uplink
  + T_turn_end_detection
  + T_model_prefill_and_reasoning
  + T_first_audio_decode
  + T_downlink
  + T_jitter_and_render
最常被低估的是 T_turn_end_detection。把静音阈值从 700 ms 降到 300 ms 可能直接节省 400 ms,却同时提高抢话率。reasoning effort 也会影响延迟;OpenAI 模型页明确提醒更高 effort 可能增加 latency 和 token。GPT-Realtime-2.1
13.2 不要只看 Time to First Audio
至少测:
| 指标 | 定义 |
|---|---|
speech_end_to_first_audio_ms | 用户实际说完到首个可播放音频 |
speech_start_to_partial_understanding_ms | 用户开始说到转写/语义状态可观察 |
barge_in_to_silence_ms | 用户插话到扬声器安静 |
tool_intent_to_call_ms | 用户意图到模型发出工具调用 |
tool_result_to_first_audio_ms | 工具完成到结果首音 |
playback_underrun_rate | 播放队列耗尽次数 |
overlap_ratio | 助手和用户不必要重叠时长占比 |
false_cut_rate | 用户未说完就被切轮次的比例 |
13.3 延迟预算只能是本地 SLO,不是行业真理
可先用以下实验预算分解问题,而不要当作 OpenAI SLA:
| 环节 | PoC 观察预算 |
|---|---|
| 采集与客户端处理 | 20–60 ms |
| 单程网络 | 30–150 ms,按地域和网络分层 |
| 轮次结束判断 | 150–800 ms,取决于策略 |
| 模型首音 | 200–1000+ ms,取决于任务、模型和 reasoning |
| 播放缓冲 | 40–150 ms |
| 打断到静音 | 目标先做 < 250 ms,再按真实设备迭代 |
这些数字是设计起点。真正 SLO 应基于目标用户、地区、设备和网络的 p50/p95/p99 数据建立。
十四、弱网、断线与会话轮换
14.1 音频不能像普通消息一样无限重试
实时音频过期很快。200 ms 前的旧音频可能值得补,5 秒前的音频通常已失去交互意义。重连策略应区分:
- Live media:有限缓冲,过期丢弃;
- Conversation event:按 event/item ID 去重;
- Tool action:必须幂等和可查询;
- Background job:可持久重试;
- Transcript/summary:异步补齐,不阻塞实时播放。
14.2 WebRTC 恢复
监控 connectionState、iceConnectionState、音频轨道 mute/unmute 和 DataChannel 状态。短抖动由协议栈吸收;长断线应结束旧 generation,重新建立 Session 或 call,并从自有 Conversation summary 恢复必要上下文。
不要承诺无缝恢复,除非当前 OpenAI API 和客户端栈已经通过真实断网测试证明 Session 可续接。
14.3 Session 轮换
由于 Realtime Session 有最大持续时间,建议提前轮换:
- 在后台生成当前会话摘要、用户偏好和未决任务;
- 暂停发起新工具写操作;
- 建立新 Session;
- 注入最小摘要与当前工具状态;
- 切换 sideband ownership;
- 旧 Session 排空并关闭。
轮换应在可控空闲点发生,不要等硬超时切断用户播报。
十五、成本与上下文:音频会话是累积计费的状态机
OpenAI Docs 说明,用户音频约每 100 ms 一个 audio token,助手音频约每 50 ms 一个 audio token;后续轮次的输入还会包含此前 Conversation。缓存可降低重复前缀成本,而持续逐条截断会破坏缓存命中。Managing costs
这意味着:
- 1 分钟用户音频约 600 audio tokens;
- 1 分钟助手音频约 1200 audio tokens;
- 长会话成本不只来自“这一句”,还来自带入下一轮的历史;
- 无意义静音、背景电视和过长播报都是真实成本;
- 提前总结和 Session 轮换可能比无限保留历史更经济。
成本控制优先级:
- 让助手短说,详细结果放屏幕;
- 不把背景噪声和无人对话持续送入有效轮次;
- 把长工具结果压成结构化最小结果;
- 长历史使用摘要和外部记忆;
- 监控 cached input、audio input/output、reasoning 和工具费用;
- 根据真实任务在主模型和 mini 模型间路由。
价格和 rate limits 变化快,报告不把当前单价固化为架构常量。
十六、安全、隐私与滥用边界
16.1 语音输入也是不可信输入
电视、广播、旁人和扬声器回声都可能产生 Prompt Injection 或误操作。必须区分:
- “模型听见了”与“用户在对助手说”;
- “用户说了”与“该用户有权限”;
- “模型选择工具”与“动作已经获批”;
- “工具返回文本”与“现实系统已验证成功”。
声纹或说话风格不能单独作为高风险身份认证。
16.2 凭据
- 长期 OpenAI API Key 只在服务端;
- 客户端使用短期 client secret;
- sideband 保存私有 instructions 和工具逻辑;
- MCP/业务凭据按用户、租户、工具和动作最小授权;
- IoT、付款、发信、删除等写操作使用短期 capability token。
16.3 数据
默认不要在普通日志记录原始音频。按目的拆分保留:
| 数据 | 推荐默认 |
|---|---|
| 原始音频 | 不保存;诊断样本需单独同意、脱敏和短保留 |
| Transcript | 按产品需要和用户同意,允许删除 |
| 语义摘要 | 最小化,只保留任务必要信息 |
| 工具参数 | 敏感字段掩码,保留审计所需字段 |
| QoE 指标 | 聚合化,不要求保留内容 |
| 失败样本 | 采样、去标识、访问受控 |
16.4 高风险动作
执行前读回关键参数,使用屏幕或第二通道确认,确认后生成不可复用的 capability token;后端用 idempotency key 确保重复工具事件不会重复执行。
十七、可观测性:把一次对话还原成可解释 Trace
推荐贯穿全链路的标识:
tenant_id
user_id
device_id
product_conversation_id
realtime_session_id / call_id
turn_id
item_id
response_id
tool_call_id
job_id
audio_generation_id
一次 Trace 应能回答:
- 用户实际何时开始和停止说话?
- 客户端用了哪个输入/输出设备和音频约束?
- VAD 何时发出事件,使用什么模式?
- 模型何时开始响应、何时产生首音?
- 客户端收到、排队和真正播放到哪一毫秒?
- 是否发生打断,谁发起 cancel,截断位置是多少?
- 工具参数从哪里来,谁授权,是否实际成功?
- 本轮用了多少音频、文本、cached 和 reasoning tokens?
- 用户最终是否听到、是否手动重试、是否纠正结果?
17.1 音频质量指标
- input clipping ratio;
- RMS / loudness 分布;
- AEC ERLE 或可用的回声残留代理指标;
- VAD speech ratio;
- packet loss、jitter、RTT;
- playback underrun;
- route change 和 AEC reconvergence 时间。
17.2 语义与产品指标
- 成功完成的用户任务;
- 首轮解决率;
- 用户纠正率;
- false tool call、duplicate action、confirmation abandonment;
- 被打断回答的比例和打断后恢复成功率;
- 长任务按时完成与结果投递率。
OpenAI Realtime 也支持 Session tracing 配置,但产品仍需要客户端声学和业务动作的自有 Trace;只有模型侧 Trace 无法解释“为什么用户听到了旧音频”或“为什么灯被重复打开”。
十八、三种落地形态
18.1 Web / Mobile MVP
TypeScript client
  - getUserMedia + RTCPeerConnection
  - remote audio element / native audio session
  - DataChannel event reducer
  - local playback and interruption UI

Node.js / Go backend
  - auth + client secret minting
  - session registry
  - sideband WebSocket
  - function tools + Capability Gateway
  - Postgres business state + optional Redis live registry
这是最快验证 GPT Live 式体验的路线。
18.2 树莓派 / 自研硬件
两条路线:
A. 设备直接 WebRTC
- Chromium kiosk/PWA,或 libwebrtc/GStreamer WebRTC;
- 媒体直接到 OpenAI;
- 自有后端只做凭据和 sideband;
- 优点是协议与抖动处理成熟,缺点是 native 集成和设备资源较重。
B. 设备到自有 Media Gateway,再用 WebSocket 到 OpenAI
- 设备用自定义 UDP/WebSocket/MQTT 音频协议到网关;
- 网关做 PCM、重采样、缓冲和 OpenAI WebSocket;
- 优点是设备轻、策略集中,缺点是网关承担全量媒体、播放游标和截断责任。
无论哪条路线,硬件必须本地完成 AEC。网关收到的只有单路混合麦克风时,已经失去最有价值的扬声器参考,无法可靠补做回声消除。
18.3 电话 Agent
- SIP trunk → OpenAI SIP;
- webhook → 自有后端;
- sideband 控制同一 call;
- Capability Gateway 执行业务;
- 必须补齐录音告知、转人工、DTMF、呼叫黑名单、地区法规和挂机清理。
十九、最小可实现接口
19.1 客户端模块接口
interface AudioFrontend {
  start(): Promise<MediaStream>;
  stop(): Promise<void>;
  getDiagnostics(): AudioDiagnostics;
}

interface RealtimeTransport {
  connect(clientSecret: string): Promise<void>;
  updateSession(patch: unknown): void;
  cancelResponse(responseId?: string): void;
  truncateItem(itemId: string, audioEndMs: number): void;
  close(): Promise<void>;
}

interface PlaybackClock {
  enqueue(generationId: string, audio: ArrayBuffer): void;
  renderedMs(generationId: string): number;
  flush(generationId: string): void;
}

interface TurnCoordinator {
  onSpeechStarted(event: unknown): void;
  onSpeechStopped(event: unknown): void;
  onResponseStarted(event: unknown): void;
  onResponseCancelled(event: unknown): void;
}
WebRTC 实现可以不直接操作原始音频 delta,但仍应暴露播放代际、停播和诊断语义。
19.2 后端 HTTP / internal APIs
POST /v1/live/sessions
  input: authenticated user, device, desired persona
  output: client_secret, product_conversation_id, policy

POST /internal/capabilities/{tool}
  input: user, tenant, call_id, tool_call_id, arguments
  output: status, result, audit_id

POST /v1/live/jobs
GET  /v1/live/jobs/{job_id}
POST /v1/live/jobs/{job_id}/cancel
不要把 sideband WebSocket 直接暴露给客户端。它属于服务端控制面。
19.3 最小持久化表
product_conversations
realtime_sessions
turns
tool_calls
confirmations
background_jobs
delivery_events
原始 audio chunk 不应进入关系数据库。实时媒体留在内存/传输栈;必要诊断录音进入受控对象存储并有独立保留策略。
二十、从 PoC 到量产的实施路线
Phase 0:先建立仪器
- 固定 5–10 台目标设备;
- 记录音频约束、RTT、VAD、首音、打断和工具时间;
- 建立可回放但受隐私控制的事件日志;
- 不先做复杂 Agent。
完成标准:任何“慢、抢话、没停住”都能定位到链路一层。
Phase 1:Push-to-talk、无工具
- WebRTC 建连;
- PTT 明确轮次;
- 原生 speech-to-speech;
- 播放与错误 UI;
- 短期凭据。
完成标准:稳定说、稳定听、弱网不崩、长期 Key 不下发。
Phase 2:全双工 VAD 与打断
- AEC/NS/AGC 基线;
server_vad和semantic_vadA/B;- cancel、flush、truncate;
- generation fence;
- 声学和竞态测试集。
完成标准:打断不自触发、不复活旧音频、历史与已听内容一致。
Phase 3:Sideband 与只读工具
- sideband 控制;
- 查询类 Function/MCP;
- tool call ledger;
- 工具失败的语音恢复;
- 权限最小化。
完成标准:模型不会把工具失败说成成功,调用可审计。
Phase 4:写工具和后台 Agent
- Capability Gateway;
- exact identifier read-back;
- 确认、幂等和补偿;
- background job 与结果投递;
- Session summary/rotation。
完成标准:重复事件不产生重复副作用,断线不丢业务结果。
Phase 5:量产治理
- 地域和机型压测;
- p95/p99 SLO;
- 成本路由和上下文治理;
- 隐私保留、删除和导出;
- 安全 red team、旁人/电视 Prompt Injection;
- 灰度、回滚和模型版本评估。
二十一、验收矩阵
21.1 声学
- 安静近讲、远讲、外放、耳机、蓝牙;
- 风扇、街道、车内、音乐、电视、人群;
- 扬声器 30% / 70% / 100% 音量;
- 单讲、双讲、用户小声插话;
- 设备路由切换与 AEC 重新收敛。
21.2 网络
- RTT 50/150/300/600 ms;
- 0/2/5/10% packet loss;
- jitter、乱序、短断网、Wi-Fi/蜂窝切换;
- DataChannel 可用但音频异常,或反向情况;
- WebSocket 背压、分片和重复事件。
21.3 会话
- 首次建连、凭据过期、模型拒绝、60 分钟轮换;
- VAD 开关与两种模式;
- 连续 cancel、truncate、响应失败;
- Conversation 过长、truncation 和缓存命中;
- 客户端崩溃后新 Session 摘要恢复。
21.4 工具与安全
- 只读与写工具策略不同;
- 参数缺失、模糊、冲突、越权;
- 工具超时、重复、部分成功、结果延迟;
- 用户取消时外部动作是否可取消;
- 电视/旁人发出高风险指令;
- 模型声称成功但工具失败时必须被阻止。
21.5 容量与成本
- 并发 Session 和 sideband 连接;
- client secret 服务峰值;
- 工具调用风暴和后台 Job 队列;
- 每分钟用户/助手音频 token;
- 长会话 cache/truncation 行为;
- 每成功任务成本,而不只每分钟成本。
二十二、OpenAI Agents SDK 开源实现提供了什么证据
2026-09-01,我们把 openai/openai-agents-python 克隆并固定在 SDK 0.22.0、commit 89c02c828ee8510fe9a84ee6675608193aa13b02。这次分析不是把 SDK 当作 OpenAI 服务端源码,而是研究 OpenAI 官方为开发者公开的应用侧参考运行时:它揭示了官方认为 Realtime Agent 需要怎样的状态、事件、竞态控制和客户端配合。
边界必须先说清楚:SDK 能证明“官方客户端/服务器应用层怎样实现”,不能证明 OpenAI 数据中心内的音频模型、VAD、推理调度、缓存或 GPU 拓扑。它也没有替开发者实现完整的浏览器 WebRTC 音频栈、业务授权、长期记忆和生产运维。
22.1 官方实际上开源了两条不同运行时
| 路径 | 源码中的结构 | 它解决什么 | 它不解决什么 |
|---|---|---|---|
| 原生 Realtime | RealtimeRunner → RealtimeSession → RealtimeModel | 持续 WebSocket、Session 本地历史、工具、审批、guardrail、handoff、音频/事件流 | 浏览器 WebRTC、麦克风/AEC、真实扬声器播放、业务权限与持久任务 |
| 链式 VoicePipeline | STT → VoiceWorkflow → TTS | 把转写、普通 Agent workflow 和流式 TTS 串成显式管线 | 原生 speech-to-speech 的副语言信息、完整双工媒体控制和可听历史同步 |
RealtimeRunner 的源码直接说明:它维护持久连接,Session 管理本地历史、工具、guardrail 与 handoff;因为代码运行在开发者服务器,所以默认使用 WebSocket。runner.py L18–L28 这与官方文档的职责分层一致,也修正了一个容易产生的误解:Python SDK 不是浏览器 WebRTC SDK。浏览器/移动端直连媒体仍应使用 Realtime WebRTC 接口;Python SDK 更适合服务端拥有 Session/媒体的 WebSocket 或 SIP 路径,以及应用侧控制逻辑。
另一条 VoicePipeline 在源码中被明确定义为三步:转写音频、运行产生文本的 workflow、把文本流转换为语音。voice/pipeline.py L21–L26 它不是 Realtime 模型的内部拆解,而是官方提供的另一种可控架构。
22.2 打断不是一个事件,而是一组跨层提交
SDK 对打断的实现几乎逐项验证了本报告第八章的状态机:
RealtimePlaybackTracker把当前item_id、content_index和已播放毫秒数建模为一等状态;自定义播放器必须在音频真正播放完成后调用on_play_bytes或on_play_ms。model.pyL18–L95- Model 读取播放状态,向应用发出
audio_interrupted,再把conversation.item.truncate限制到已收到音频的合法范围;必要时发送response.cancel。openai_realtime.pyL1027–L1178 - 被打断的
response_id被加入 generation fence,随后到达的旧response.audio.delta直接丢弃,直到 response 完成后才释放索引。openai_realtime.pyL1184–L1207 ·openai_realtime.pyL1295–L1317 - SDK 只发出“应停止播放”的事件,物理 flush 仍由播放端完成。官方浏览器示例在
audio_interrupted时清空 JavaScript 待播数组,并向AudioWorklet发送stop;Worklet 再清空自己的 PCM 队列。app.jsL296–L317 ·app.jsL687–L703 ·audio-playback.worklet.jsL42–L60
最重要的修正是:SDK 的默认播放进度只是“收到第一块音频后按单调时钟推算”,它假设立即、实时速率播放;只有自定义 tracker 才能表达队列、设备或远端电话的真实播放进度。model.py L130–L139 · openai_realtime.py L999–L1018
这意味着本报告原有结论需要被写得更精确:
播放游标不只是建议,而是官方 SDK 的一等抽象;但 SDK 默认值仍是近似值。只要存在抖动缓冲、蓝牙、远端电话、系统混音或播放器排队,就必须让真实播放回执驱动 tracker,不能把“网络已收到”当作“用户已听到”。
Twilio 示例给出了正确参考:每个外发音频块后发送 mark,等 Twilio 回传该 mark 后才调用 playback_tracker.on_play_bytes;发生打断则向远端媒体流发送 clear。twilio_handler.py L149–L186 · twilio_handler.py L234–L247 相比之下,浏览器示例能 flush,但没有把逐 item 的真实声卡播放进度回传给 SDK,因此它仍是演示骨架,不是本报告所要求的产品级可听历史实现。
22.3 RealtimeSession 的确是一个 Session Actor
源码把本报告中的“Session Actor”从架构类比提升为可观察实现:RealtimeSession 单独持有当前 Agent、本地历史、事件队列、待审批工具、活动工具、待发送输出、被打断 response,以及当前/最新输出 generation。session.py L175–L260
它还有三个值得直接借鉴的并发原则:
- 传输循环不等待工具完成:工具默认作为后台 task 执行,避免业务 I/O 阻塞实时事件处理。
session.pyL1872–L1897 - 取消必须绑定 generation/response:旧 response 的 guardrail 结果只能停止它自己的播放,不能取消已经开始的新 response;反馈消息还要在传输提交边界重新检查 generation。
session.pyL1632–L1751 - “先检查、再 await send”不具备原子性:
RealtimeModel.send_event_if的默认实现宁愿返回False,也不在条件可能过期后发送事件;自定义 transport 必须在真正提交边界重检或串行化条件。model.pyL174–L187
因此我们自己的 Turn Coordinator 不应只有 is_interrupted 布尔值,而应至少以 (session_id, response_id, generation, item_id, content_index) 建立因果边界;所有迟到音频、guardrail、工具结果和自动续答都必须先验证自己仍属于当前 generation。
22.4 SDK 提供工具控制原语,但不是 Capability Gateway
SDK 已经处理了很多容易被低估的应用层细节:动态判断 needs_approval、保存 pending call、发出 RealtimeToolApprovalRequired,防止同一 call_id 被换成另一种工具调用,后台执行工具,并在 handoff 时先切换当前 Agent 和 Session 配置,再提交会触发新 response 的 tool output。session.py L698–L783 · session.py L1059–L1152 · session.py L1263–L1330
但这没有推翻 Capability Gateway 的必要性:SDK 的 approval 是编排原语,不知道租户权限、支付限额、设备所有权、业务幂等键、补偿事务、审计留存和真实系统是否成功。handoff 也只是当前 Session 内的 Agent/Prompt/tools 配置切换,不是媒体连接迁移,更不是 durable 后台任务调度。
22.5 VoicePipeline 适合可控链路,但不能冒充原生 Realtime
VoicePipeline 支持静态音频和流式输入;多轮模式从流式 STT 取出一个个转写 turn,运行 workflow,再把文本交给 TTS。voice/pipeline.py L58–L75 · voice/pipeline.py L123–L196 SingleAgentVoiceWorkflow 把转写加入文本历史,使用普通 Runner.run_streamed() 产生文本 delta,并保存最后一个 Agent。voice/workflow.py L62–L113
它的 TTS 实现会按句段并发启动合成任务,再通过本地队列按原始顺序输出音频,证明“并发生成、顺序提交”是降低延迟又保持语序的可用模式。voice/result.py L217–L306
但源码也清楚显示了边界:StreamedAudioInput 只是一个默认无界的 asyncio.Queue,voice/input.py L115–L130 不提供采集、AEC、播放回执、网络背压或语义截断。它适合稳定转写、审计、固定流程和可替换 STT/TTS 的场景;若目标是 GPT Live 式原生副语言理解、全双工插话和精确可听历史,仍需 Realtime 路径与独立媒体控制面。
22.6 官方浏览器示例证明了客户端职责,也暴露了生产缺口
示例客户端使用 getUserMedia 请求 24 kHz 单声道、echoCancellation 和 noiseSuppression,再用 AudioWorklet 转成 PCM16。app.js L211–L257 播放端同样由独立 Worklet 管理 PCM 队列与 stop/drain。audio-playback.worklet.js L1–L120
这证实 AEC、采集、格式转换、播放队列和物理停播属于客户端。但该示例把 Int16Array 展开成 JSON 数组,经本地 ws://localhost 发往 Python 后端,app.js L103–L115 · app.js L243–L253 没有生产级二进制 framing、显式背压、重连、抖动统计、设备路由治理或播放 acknowledgement。它应被当作 API/事件演示,不应反过来否定报告对 WebRTC 直连和产品级 Audio Engine 的建议。
22.7 观测默认值会直接影响隐私边界
链式 VoicePipeline 默认开启 tracing,并默认把敏感文本和音频包含在 trace 中。voice/pipeline_config.py L20–L31 这不是漏洞,而是一个需要应用显式决策的默认值。生产环境必须根据录音同意、保留周期、地域和租户隔离设置 tracing_disabled、trace_include_sensitive_data、trace_include_sensitive_audio_data 或自定义 tracing processor,不能只在日志层“少打印一点”。
22.8 对现有报告的影响
| 现有判断 | 源码分析后的状态 | 新增精度 |
|---|---|---|
| Realtime Session 应视为 Session Actor | 确认 | SDK 显式持有历史、队列、pending tools、interrupted responses 和 generation 状态 |
| 打断需要 cancel + flush + truncate + fence | 确认 | SDK 实现 response cancel、item truncate、audio_interrupted 与迟到 audio delta 抑制;播放器 flush 仍由应用完成 |
| 客户端播放游标是可听历史事实源 | 强化 | 官方提供 RealtimePlaybackTracker;默认到达时钟只适合低延迟近似,远端/排队播放必须接真实回执 |
| 浏览器/移动端优先 WebRTC | 不变 | Python Realtime SDK 默认是服务器 WebSocket;官方浏览器示例的应用 WebSocket 只是 demo 拓扑 |
| 工具调用必须经过 Capability Gateway | 不变 | SDK 有审批、去重和 handoff 原语,但没有业务授权、幂等、补偿与业务事实治理 |
| 链式管线与原生 Realtime 是不同路线 | 确认 | VoicePipeline 源码就是显式 STT → workflow → TTS,而不是 Realtime 模型内部实现 |
| 并发必须按 response/generation 隔离 | 强化 | SDK 用 generation-scoped guardrail、response fence 和提交边界条件发送处理竞态 |
因此,这次开源分析不是推翻报告,而是把它从“官方协议 + 工程推断”推进到“官方协议 + 官方应用运行时源码 + 工程推断”。如果由我们实现,可选择复用 Agents SDK 的 Session、工具、审批、guardrail、handoff 与 tracing 原语,但仍应自行实现或接入生产级 Audio Engine、WebRTC/设备媒体、Playout Ledger、Capability Gateway、durable Task/Memory 和跨层观测。
22.9 源码验证结果
- 固定快照:
openai-agents-python0.22.0,commit89c02c828ee8510fe9a84ee6675608193aa13b02,MIT License。 - 离线执行
tests/realtime与tests/voice:727 passed,0 failed,4.58s。 - 测试覆盖了自定义/默认 playback tracker、截断边界、response-scoped cancellation、迟到旧音频抑制、guardrail generation 竞态、工具审批/去重/handoff,以及 VoicePipeline 的流式处理和错误清理。
- 这些结果验证的是该固定提交的 SDK 应用层行为;没有调用 OpenAI Realtime API,因此不构成真实网络、模型、音质、端到端延迟或服务端内部实现的验证。
二十三、最终架构判断
如果由我实现一款基本相似于 GPT Live 的应用,我会选择:
- 浏览器/移动端直连 WebRTC,把媒体延迟和工程负担降到最低;
- 本地音频前处理优先,AEC 是外放全双工的硬前提;
- OpenAI Realtime 作为短生命周期 Session Actor,负责原生语音理解、生成、轮次事件和工具决策;
- 自有后端使用 sideband,私有 Prompt、工具、状态和业务策略不下发客户端;
- Capability Gateway 收口所有真实副作用,模型调用不是授权;
- Turn Coordinator 显式管理打断,用播放游标、截断和 generation fence 保持声学现实与语义历史一致;
- 长期状态和长任务在 Session 外持久化,Realtime 前台永远保持轻、快、可打断;
- 选择性复用 Agents SDK,把它当作服务端 Session/Agent 运行时,而不是浏览器媒体栈、业务权限系统或 durable runtime;
- 从第一天记录 QoE 与业务 Trace,并显式关闭或脱敏不符合隐私策略的音频/文本 tracing;没有跨层观测就无法优化“自然感”。
真正应该逆向学习的,不是猜 OpenAI 内部有几个模型,而是它通过公开协议暴露出的系统思想:
实时语音不是一次请求,而是媒体流、轮次、生成、播放、对话历史和现实行动共同推进的一段分布式状态机。
只要这段状态机没有被完整实现,模型再强也只会得到一个“能说话的 Demo”;只有客户端、传输、模型、控制面和业务执行在同一套同步与验证规则下工作,才会得到一款类 GPT Live 产品。
Source Manifest
Sources
- 引用 Codex 任务:终态投影规则 — 用户关于主流语音架构、GPT Live、客户端/OpenAI 服务端职责、树莓派/IoT、混合架构与打断机制的连续讨论;本报告按最终讨论状态整理,不把更早的粗略说法固化为事实。
- 当前用户需求:基于公开资料,从音频、AI 与后端专家视角 clean-room 还原 OpenAI Realtime API 端到端实现,并给出类 GPT Live 自建架构;后续要求克隆并分析 OpenAI 已开源的 Agents SDK,把可复现源码作为增量证据完善原报告,而不是推翻原报告。
- Realtime and audio overview — 连接方式与入口选择。
- Realtime API with WebRTC — 短期凭据、SDP、MediaStream Track 和 DataChannel。
- Realtime API with WebSocket — server-to-server 与 Base64 音频责任。
- Realtime API with SIP — 电话接入、webhook 与 call lifecycle。
- Realtime conversations — Session/Conversation/Item/Response、音频事件、Function Calling、打断和截断。
- Voice activity detection —
server_vad、semantic_vad和 speech events。 - Realtime with tools — Function 与 MCP 工具。
- Webhooks and server-side controls — WebRTC/SIP sideband 控制通道。
- Voice agents — speech-to-speech 与 chained pipeline 的官方架构区分。
- OpenAI Agents SDK Realtime quickstart —
RealtimeAgent、RealtimeRunner、RealtimeSession、音频输入输出与事件消费。 - OpenAI Agents SDK Realtime guide — Realtime Session、tools、handoffs、guardrails、SIP 和 playback tracking 的 SDK 抽象。
- OpenAI Agents SDK VoicePipeline quickstart — STT → workflow → TTS 链式语音管线。
- OpenAI Agents SDK Python 固定源码
89c02c8— SDK0.22.0的可复现源码快照;重点核对src/agents/realtime/、src/agents/voice/、浏览器示例、Twilio 示例及对应测试。 - Using realtime models — 工具确认、失败恢复和静音/背景音处理。
- Managing costs — audio token、缓存与 truncation。
- GPT-Realtime-2.1 model — 当前模型能力、context、reasoning 与 modality 快照。
- W3C Media Capture and Streams — AEC、NS、AGC、采样率与 latency constraints。
- W3C WebRTC 1.0 —
RTCPeerConnection、ICE 和 WebRTC API。 - RFC 8835: Transports for WebRTC — SRTP、DTLS-SRTP、ICE 和 DataChannel transport。
- RFC 7587: Opus RTP Payload — WebRTC 实时音频常用 Opus/RTP 标准。
- WorkBuddy Cloud Agent 对接指南 — 设备语音前台、业务控制面、长任务 Agent 和 Capability Gateway 的既有产品化分析。
Produced artifacts
outputs/reports/20260823_OpenAI Realtime API 端到端实现逆向分析:从客户端音频到实时语音模型.mdoutputs/reports/assets/OpenAI-Realtime-API-端到端实现/generated/01-realtime-four-planes.pngoutputs/reports/assets/OpenAI-Realtime-API-端到端实现/generated/02-client-acoustic-loop.pngoutputs/reports/assets/OpenAI-Realtime-API-端到端实现/generated/03-interruption-three-way-sync.pngoutputs/reports/assets/OpenAI-Realtime-API-端到端实现/generated/imagegen-manifest.mdsynthesis/实时语音 Agent 端到端架构.mdindex.md中的 Synthesis、Outputs 与 Recently Updated 登记。log.md中的单行output记录。
Key decisions
- 采用 clean-room 协议分析,不推断为已知的 OpenAI 内部代码或模型拓扑。
- 把端到端系统拆为媒体、会话、业务行动、观测治理四个平面。
- Web/移动端首选 WebRTC 直连;业务后端使用同 Session sideband,而不是转发全部媒体。
- Function/MCP 的工具选择与真实业务授权分离,所有副作用进入 Capability Gateway。
- 打断以“声学同步 + 播放同步 + 语义同步”为核心,明确 WebRTC/SIP 与 WebSocket 的截断责任差异。
- Realtime Session 只承载短期实时交互;长期状态与后台 Agent/Job 在自有系统持久化。
- Agents SDK 只作为可选的开发者侧 Session/Agent 运行时;不把它误当成 OpenAI 服务端源码、浏览器 WebRTC 实现、Capability Gateway 或 durable runtime。
- 自定义播放 tracker 必须由真实播放回执驱动;默认“收到后立即实时播放”的时钟只作为低延迟近似。
Verification evidence
- 已实际打开并核对上述 OpenAI Docs 页面,而非只使用搜索摘要。
- 已核对截至 2026-08-23 的
gpt-realtime-2.1模型页与当前 Realtime guide。 - 已把引用任务中的结论与当前官方 interruption/truncation、VAD、sideband 和 tools 契约逐项对照。
- 报告中的三张 Mermaid 图已通过 Mermaid CLI 实际语法和渲染检查。
- 三张 ImageGen 信息图已按原始分辨率检查中文、箭头、职责边界与虚构数据;客户端声学图因初版回声箭头歧义而重做,最终版通过 3/3。
- 第三张信息图仅使用 ImageMagick 将透明画布铺为暖白色不透明背景,保证 Obsidian 深浅主题可读;未修改图形、文字或含义。
- 报告、综合页、
index.md与log.md已通过项目 Obsidian Markdown lint,未发现语法问题。 - 已使用 W3C/IETF 原始标准核对 WebRTC、Media Capture、SRTP/ICE/DataChannel 和 Opus 的协议边界。
- 已克隆
openai/openai-agents-python并固定到89c02c828ee8510fe9a84ee6675608193aa13b02,逐文件核对 Realtime Runner/Session/Model、打断与 playback tracker、工具/审批/guardrail/handoff、VoicePipeline、浏览器 AudioWorklet 与 Twilio mark/clear 实现。 - 在独立临时 virtualenv 中执行固定快照的
tests/realtime与tests/voice:727 passed、0 failed、4.58s。仓库未被修改,工作区未引入 SDK 依赖。 - 未调用 OpenAI Realtime API,未执行真实 WebRTC/WebSocket 建连、设备声学测试或生产压测;实现参数和 SLO 仍需 PoC 校准。
Open questions / risks
- OpenAI 未公开 Realtime 模型内部音频表示、服务端调度、VAD/主模型拓扑和 ChatGPT GPT Live 的后台 Agent 路由。
- Agents SDK 源码只能证明开发者侧运行时与示例行为,不能证明 OpenAI 托管 Realtime 服务内部实现;SDK 后续提交也可能改变这些机制。
- 当前模型、字段、Session 时长、价格和配额可能变化,实施前必须重新核对官方文档。
- 浏览器声明支持 AEC/NS/AGC 不代表目标硬件达到外放双讲质量;真实设备测试是量产门禁。
- 弱网恢复、Session 轮换和 sideband 高可用需要真实故障注入验证,不能仅凭协议文档推断。
- 高风险工具、声纹身份、录音保留、跨境处理和未成年人语音场景需要独立安全与合规评审。