开源实时语音 AI 项目深度横评
从媒体基础设施、Agent 编排到原生音频模型
本报告比较 15 个与实时语音 AI 直接相关的开源项目。它不是按 Star 或 README 功能数量排行,而是基于 2026-08-24 的原始横评快照,以及 qwen-audio-agent 于 2026-08-28 固定的官方仓库、commit、文档和关键源码,检查媒体、声学、轮次、模型、Agent、终端、部署与开源边界。OpenAI Realtime API 只作为闭源能力基准,不参与“开源完整度”比较。所有“最佳”都限定在特定职责和场景;未执行真实 Provider 账户、设备声学矩阵与生产压测的项目,不把文档能力写成已验证 SLA。
如果只读一页
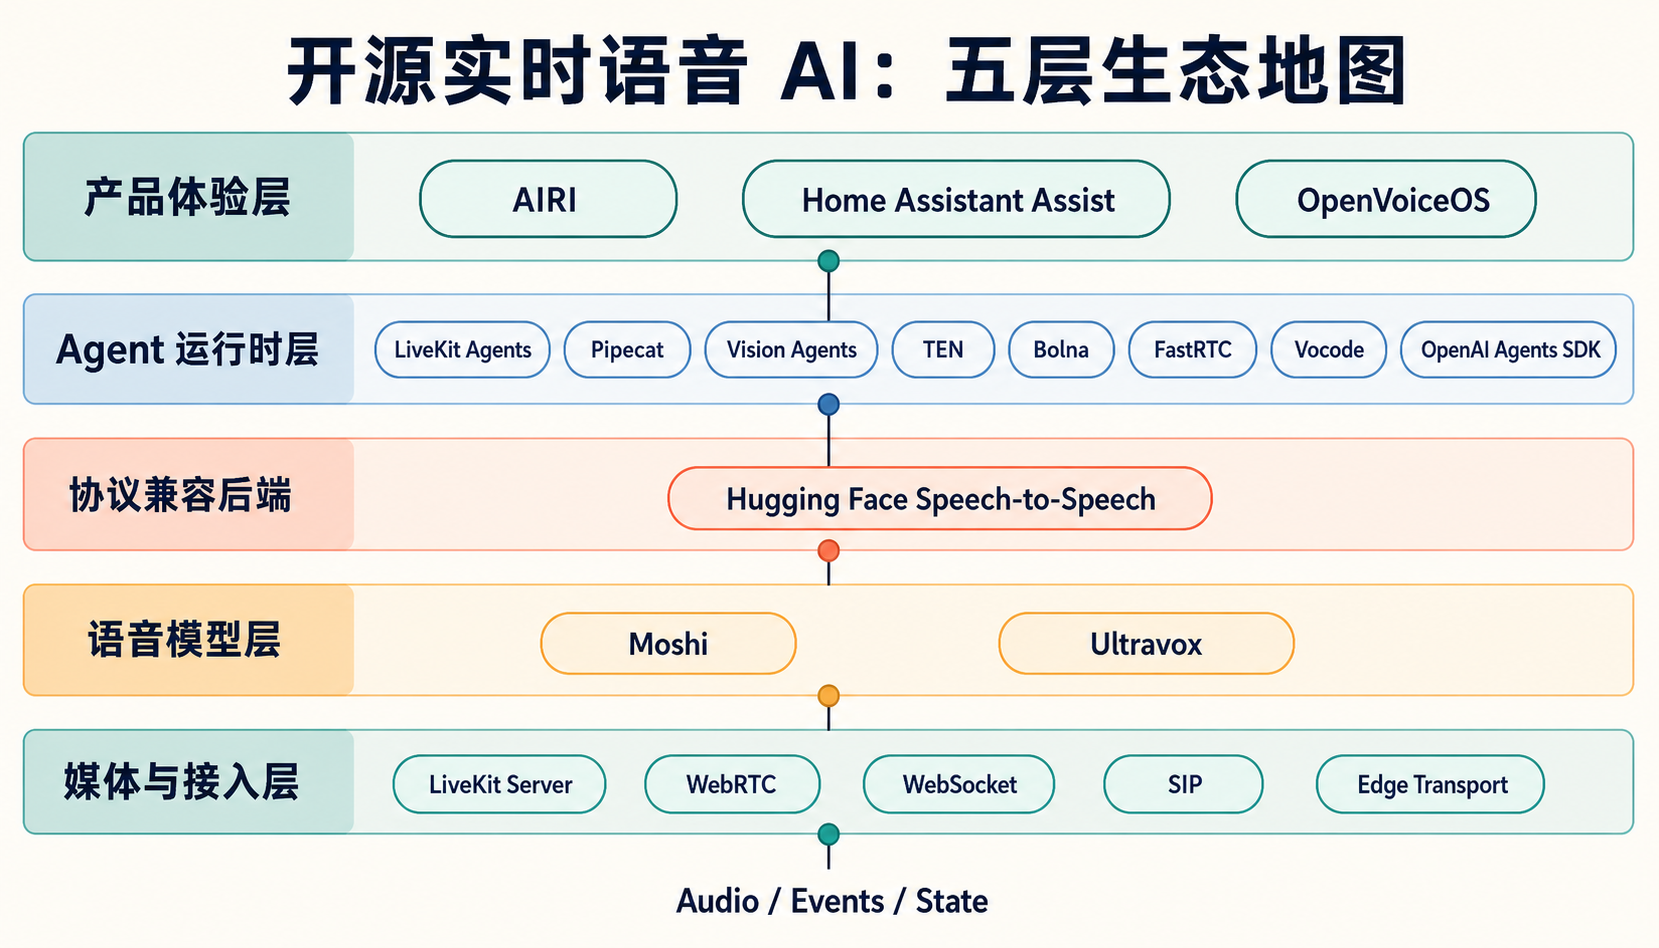
没有一款项目是所有场景的总冠军,因为它们根本不在同一层。 LiveKit 首先是媒体基础设施与 Agent runtime,Pipecat 是 provider-neutral 的实时管线框架,Hugging Face Speech-to-Speech 是兼容 OpenAI Realtime 核心事件面的自托管级联后端,Moshi 是原生全双工语音模型,qwen-audio-agent 是本地 Gateway 驱动的双速 Agent runtime,AIRI 则是数字伙伴产品外壳。把这些项目直接按“功能多少”排序,就像把 Kubernetes、FastAPI、Llama 和一个完整桌面应用放进同一张榜单。
| 目标 | 首选 | 为什么 | 主要边界 |
|---|---|---|---|
| 生产级 Web / App / SIP 实时 Agent 平台 | LiveKit | 开源 SFU、Room、Agent 调度、客户端 SDK、SIP、级联与 Realtime 模型共用一套运行时 | 自托管网络和 TURN 运维较重;Cloud 增强能力不等于开源 Server |
| Provider-neutral 的语音 / 多模态编排 | Pipecat | Frame Processor 与 Pipeline 把 VAD、STT、LLM、TTS、S2S、transport、工具和观测解耦 | 不是 SFU;媒体质量和可听历史仍取决于所接 transport / client |
| 自托管 OpenAI Realtime 兼容后端 | Hugging Face Speech-to-Speech | WebSocket / WebRTC、核心 GA 事件、官方 Agents SDK 兼容、VAD→STT→LLM→TTS 全部可替换 | 不是原生 speech-to-speech;只覆盖核心事件面;WS truncate 仍是 no-op |
| 音频 + 视频实时 Agent | Vision Agents | EdgeTransport、Realtime / Cascade 双流、视频处理器、MCP、RAG、内存和完整指标面 | 默认 Stream Edge 是商业服务;项目本身不是可自托管 SFU |
| 电话 Agent | Bolna;复杂平台看 Pipecat / LiveKit SIP | 电话 Provider、输入输出流、级联语音链与中断是主路径 | 开源 orchestration 与托管 API / UI 的边界需单独审计 |
| 家庭与本地硬件语音 | Home Assistant Assist + Wyoming | 本地 wake word、STT、intent、TTS 和卫星协议已形成设备生态 | 面向家庭控制管线,不是通用的长对话 Agent runtime |
| 数字伙伴 / 虚拟角色产品 | AIRI | Web / Desktop、WebAudio、TTS、头像、记忆、游戏连接与成熟播放队列 | 是产品体验层,不是通用媒体后端、SFU 或电话平台 |
| 单用户桌面语音编码 Agent | qwen-audio-agent | 本地 Gateway 统一语音 Session、权限与客户端所有权;Task / BackendPort / ACP 将长工作做成可恢复后台任务 | PCM over WS 只适合本机入口;默认模型托管;没有 WebRTC / SIP / SFU、多租户或精确可听历史截断 |
| 原生全双工模型研究 | Moshi | 双音频流、Mimi codec、流式推理和开放权重形成完整研究基线 | 工具、权限、业务状态、终端和生产调度仍要外建 |
| 快速 Python 原型 | FastRTC | 将函数快速包装为 WebRTC / WebSocket 音视频应用 | 平台治理、会话一致性与大规模运维不是它的核心职责 |
| OpenAI 原生路径 | OpenAI Agents SDK | RealtimeAgent 和 VoicePipeline 与 OpenAI 工具生态衔接最直接 | SDK 开源不代表 Realtime 模型、媒体服务和控制面开源 |
三个最重要的判断
- “像 GPT Live”首先是系统属性,不是模型属性。 双讲、打断、迟到音频隔离、客户端真实停播、已听历史截断、工具权限和断线恢复,任何一项缺失都会让原生语音模型变成不可靠的 Demo。
- 真正的开源替代通常是组合,而不是单仓库。 例如 LiveKit Server 负责媒体,Pipecat 或 LiveKit Agents 负责运行时,HF Speech-to-Speech 负责本地级联推理,AIRI 负责产品体验。
- 最值得优先 PoC 的新增项目是 HF Speech-to-Speech、Vision Agents 与 qwen-audio-agent。 前者把 OpenAI Realtime 客户端协议和本地模型链连接起来;后者把语音 Agent 的问题扩展为音视频实时状态机;Qwen 则补足了“实时对话不阻塞、后台 Agent 可恢复执行”的产品运行时。AIRI 仍最适合研究“语音能力如何成为完整产品”,而不是研究后端媒体平台。
一、范围、方法与证据边界
1.1 横评范围
本次覆盖:LiveKit、Pipecat、TEN Framework、Bolna、FastRTC、Vocode、OpenAI Agents SDK、Home Assistant Assist + Wyoming、OpenVoiceOS、Ultravox、Moshi、AIRI、Hugging Face Speech-to-Speech、GetStream Vision Agents、qwen-audio-agent。
其中 Home Assistant Assist 与 Wyoming 按一套“家庭语音管线 + 分布式语音服务协议”评估;OpenAI Agents SDK 评估的是开源 SDK,OpenAI Realtime API 仅作为它所依赖的闭源服务边界;Ultravox 与 Moshi 评估的是开放模型 / 推理栈,不把它们误写成完整 Agent 平台。
1.2 九个评价维度
| 维度 | 真正要问的问题 |
|---|---|
| 媒体与传输 | 是否拥有 WebRTC / WebSocket / SIP、抖动、背压、重连、多人房间或可替换 transport? |
| 客户端声学 | AEC、NS、AGC、设备切换、播放队列和真实停播由谁负责? |
| 轮次与打断 | 是否只有 VAD,还是同时完成判决、取消、flush、旧 generation fencing 与历史投影? |
| 模型路径 | 支持级联、原生 Realtime、half-cascade、本地模型和 Provider 替换到什么程度? |
| Agent 编排 | 工具、MCP、记忆、RAG、多 Agent、后台任务和会话状态是否进入统一 runtime? |
| 客户端与入口 | Web、iOS、Android、桌面、电话、机器人、家庭卫星和视频分别是否一等公民? |
| 部署与扩展 | 单会话隔离、Worker 调度、水平扩展、GPU 服务、区域共置和故障恢复如何实现? |
| 可观测与治理 | 是否有逐阶段 latency、队列、turn、工具、音频和 trace,而不只记录模型耗时? |
| 开源边界 | 代码、模型权重、媒体网络、托管控制面和运维闭环是否分别可自托管?许可证是否有限制? |
1.3 评价符号
◎:项目的一等公民或核心实现。○:官方支持且有明确实现路径。△:需要外部集成、仅覆盖部分链路,或最终质量由调用方负责。—:不是该项目核心能力。⚠:存在闭源、托管依赖、受限许可或明显维护风险。
这些符号表达“职责覆盖”,不是线性总分。一个专注的模型项目在平台列得分低,并不意味着模型本身质量差。
1.4 固定证据快照
| 项目 | 固定 commit | 代码许可证 / 开放边界 | 2026-08-24 判断 |
|---|---|---|---|
| LiveKit Agents | 3bf38c78 | Apache-2.0;Cloud 增强另算 | 活跃,生产平台型 |
| Pipecat | acead050 | BSD-2-Clause | 活跃,框架型 |
| TEN Framework | 2e56d965 | Apache-2.0 文本外加设备部署与竞争限制 | 活跃,但必须法务审计 |
| Bolna | 0172347b | MIT;Hosted APIs / UI 另算 | 活跃,电话优先 |
| FastRTC | f9395ea2 | MIT | 活跃度中等,原型工具型 |
| Vocode | e054c33a | MIT | 仓库寻求维护者,最后 push 为 2024-11,视作 legacy |
| OpenAI Agents SDK | fe45b415 | MIT SDK;模型 / Realtime 服务闭源 | 活跃,vendor-native |
| Home Assistant Core | 207c4f04 | Apache-2.0 | 活跃,本地家庭生态 |
| Wyoming | bf65f4e6 | MIT | 活跃,协议 / 卫星层 |
| OpenVoiceOS | b135f2c6 | Apache-2.0 | 活跃,嵌入式语音 OS |
| Ultravox | 69ddc63b | MIT 代码;权重按具体版本 / backbone 审计 | 模型型;不是音频输出平台 |
| Moshi | e6a55d27 | Python / Web MIT,Rust Apache-2.0,模型权重 CC-BY 4.0 | 原生全双工研究基线 |
| AIRI | f14a7ac9 | MIT | 高活跃,产品体验型 |
| HF Speech-to-Speech | 9f59bc72 | Apache-2.0;所接模型许可证另算 | 高活跃,协议兼容后端型 |
| Vision Agents | e5d60179 | Apache-2.0;默认 Stream Edge 为商业网络 | 高活跃,音视频 runtime 型 |
| qwen-audio-agent | 8565c03c | Apache-2.0 runtime;默认 Realtime Provider/模型另算 | 开发态,本地单用户双速 Agent runtime |
TEN 的 LICENSE 明确加入了“不在终端设备托管”以及“不与 Agora 竞争”等额外条件,因此不能仅凭 README 中的 “Apache 2.0” 字样把它视为标准、无附加限制的 Apache-2.0 项目。TEN LICENSE
二、先分类:五层生态,而不是一条榜单
2.1 媒体与接入层
这一层负责“声音怎样可靠地到达对方”:采集、RTP、WebRTC、ICE/TURN、SFU、SIP、重连、抖动与多人房间。横评项目中只有 LiveKit Server 是完整的开源 SFU / Room 媒体底座;Vision Agents 的 EdgeTransport 是抽象层,默认 Stream Edge 是商业服务;Pipecat、TEN、FastRTC 等可以接 WebRTC transport,但不因此变成 SFU。
2.2 Agent 运行时与管线层
这一层负责“音频进入后怎样变成一个可取消、可观测、可调用工具的会话”:LiveKit Agents、Pipecat、Vision Agents、TEN、Bolna、FastRTC、Vocode 和 OpenAI Agents SDK 都在这里,但抽象不同:
- LiveKit 以 Room / Participant / Track 和
AgentSession组织会话。 - Pipecat 以 Frame、Processor 和 Pipeline 组织数据流。
- TEN 以 extension graph 组织实时多模态组件。
- Vision Agents 以
EdgeTransport、Agent 和 inference flow 组织音视频会话。 - Bolna 围绕电话媒体流和级联 Provider 编排。
- FastRTC 围绕 Python handler 快速形成可运行 RTC 应用。
- OpenAI Agents SDK 围绕 OpenAI Realtime 或
VoicePipeline编排 Agent。 - qwen-audio-agent 以本地 Gateway 持有实时语音 Session、客户端 owner、权限和通知,再将长工作移交 TaskManager、BackendPort 与 ACP Agent Session。
2.3 协议兼容后端层
HF Speech-to-Speech 是本次横评中最独特的一层。 它在 FastAPI / uvicorn 上提供 OpenAI Realtime GA 核心事件面的 WebSocket 与 WebRTC 入口,每个 Session 内运行 VAD、STT、LLM、TTS 线程与队列,并用 OpenAI 官方 Agents SDK 做兼容测试。它让现有 Realtime client 可以换到本地级联后端,但它不是 OpenAI 完整协议的逐项克隆,也不是一个端到端神经 speech-to-speech 模型。OpenAI Realtime compatibility
2.4 模型层
- Moshi 同时生成 / 理解双向音频流,最接近“开放的原生全双工语音模型”。
- Ultravox 把音频投影进语言模型并流式输出文本,本质是音频理解模型;音频回复仍需额外 TTS,因此不能把它写成完整 speech-to-speech 平台。
2.5 产品体验与设备层
- AIRI 展示了虚拟角色、记忆、Web / Desktop、WebAudio、TTS、游戏连接和播放管理如何合成一个数字伙伴。
- Home Assistant Assist + Wyoming 展示了 wake word、STT、intent、TTS 与局域网语音卫星如何形成可本地运行的家庭设备系统。
- OpenVoiceOS 展示了消息总线、skills、persona、插件和嵌入式镜像如何形成一个语音助手操作系统。
三、横向能力矩阵
3.1 架构与模型路径
六个横向指标分别在测什么
这六列不是六个可以相加的功能勾选框,而是在检查一套实时语音系统的不同责任层:声音如何进入系统、如何传输、如何经过模型、如何执行动作,以及整条链最终由谁掌控。
| 指标 | 本报告中的定义 | 什么情况算高覆盖 | 什么不算 |
|---|---|---|---|
| 媒体底座 | 承接实时音频/视频的长期基础设施,包括媒体 Session、发布订阅或流路由、抖动与背压、重连、多人/多路媒体以及电话或设备入口。它回答“声音怎样可靠地进入、离开并在参与者之间流动”。 | 项目自己提供可复用的 Room/SFU、RTC 服务、电话媒体层或明确的 transport runtime,并掌握媒体连接与路由状态。 | 只调用一个模型 Provider 的 WebSocket;只提供一次请求式音频上传;Demo 中能录音和播放,但没有可复用媒体会话层。 |
| WebRTC / WS | 项目是否提供实时双向网络入口。WebRTC(Web Real-Time Communication)面向实时媒体,原生处理 ICE/NAT、加密媒体、抖动、丢包与拥塞;WS(WebSocket)是有序双向消息通道,音频 framing、节奏、抖动与播放通常由应用补齐。斜杠表示“可采用的入口集合”,不表示两者等价,也不要求每个项目必须同时实现。 | 至少一种入口是一等能力,具备持续双向流、生命周期、取消/断线处理和清楚的客户端实现;同时支持 WebRTC 与 WS 时覆盖面更完整。 | 只有 REST 上传;底层库理论上能开 WebSocket,但项目没有音频事件合同;使用某家托管 RTC 不等于项目拥有可自托管 WebRTC 媒体网络。 |
| 级联管线 | 将语音链拆成 VAD/Turn → STT → LLM → TTS → Playback 等可独立替换、流式运行和取消的阶段。它回答“能否组合不同模型,并观察每一段的状态和延迟”。 | STT、LLM、TTS、VAD/turn、队列和取消拥有明确接口;支持流式衔接、Provider 替换、backpressure、generation fencing 与逐阶段观测。 | 在一个函数里顺序调用三次 API;只能整体替换固定 Provider;虽然有 STT 和 TTS,但没有流式取消、队列或轮次状态。 |
| 原生 Realtime / S2S | Realtime 在本报告中指持久低延迟 Session:持续接收音频/事件、增量输出并支持 turn、cancel、tool 等实时语义;S2S(Speech-to-Speech)指模型或服务直接从语音上下文生成语音,而不是应用显式串联 STT→文本 LLM→TTS。 | 项目拥有原生双向音频模型/推理栈,或把外部 Realtime/S2S Provider 作为一等模型路径,并正确桥接音频、事件、打断和工具语义。矩阵中的“接 Provider”只表示集成能力,不表示项目拥有该模型。 | 只有 streaming STT;音频输入后只输出文本;普通文本 LLM 加一个 TTS 包装;把级联链营销为“speech-to-speech”,但中间阶段仍由应用显式拼接。 |
| 工具 / Agent | 语音会话是否能安全地读取状态、调用结构化工具、执行真实动作并继续对话。Agent 不只等于模型支持 function calling,还包括 Session 状态、权限、超时、取消、结果回填、记忆/上下文和可观测生命周期。 | 工具调用进入统一 runtime,具有 schema、上下文、错误/取消处理和结果回填;进一步支持 MCP、RAG、记忆、多 Agent 或后台任务。 | Prompt 中让模型“假装执行”;只能输出 JSON 但没有执行器;Provider 支持 tools,而项目本身没有把工具状态接入语音 Session。 |
| 完全自托管路径 | 是否存在一条从客户端接入、媒体/会话、模型推理到 Agent/工具执行都可运行在自有基础设施上的端到端组合路径,且没有强制依赖闭源媒体网络、托管控制面或专有模型 API。这里评估的是“可行路径”,不是“单仓库打包了所有组件”。 | 核心代码可部署,媒体入口可自建,模型可换成本地或开放权重实现,Agent/工具不依赖强制 SaaS;许可证允许目标部署方式。 | SDK 开源但 Realtime 模型必须调用闭源 API;Agent 框架可自建但媒体只能走商业 edge;仓库能本地启动 UI,却仍强制依赖云端语音模型。可选 Cloud、电话运营商或外部模型不会自动否定自托管,前提是存在不依赖它们的替代路径。 |
如何同时阅读这六列
- 媒体底座与 WebRTC / WS 不是同一件事:前者是长期媒体责任与状态权威,后者只是接入协议。FastRTC 能快速提供 WebRTC 入口,不等于拥有 LiveKit 式 SFU/Room 平台。
- 级联管线与原生 Realtime / S2S 通常是替代模型路径:前者可拆、可换、容易治理;后者跨越传统 STT/TTS 边界,通常延迟更低、韵律信息保留更多,但 Provider/模型耦合更强。
- 工具 / Agent 位于模型外层:即使 Moshi 一类模型能原生双讲,权限、幂等业务动作、长期记忆和后台任务仍需要 Agent runtime 或业务控制面。
- 完全自托管是整条链的属性:某一层开源不代表系统完全可控;反过来,一个项目没有自带 SFU,只要允许组合自托管 transport 与本地模型,也可能形成完整自托管路径。
项目对照
| 项目 | 媒体底座 | WebRTC / WS | 级联管线 | 原生 Realtime / S2S | 工具 / Agent | 完全自托管路径 |
|---|---|---|---|---|---|---|
| LiveKit | ◎ SFU / Room | ◎ | ◎ | ◎ 接 Provider | ◎ | ◎,Cloud 增强除外 |
| Pipecat | △ 接 transport | ◎ | ◎ | ◎ 接 Provider | ◎ | ○,取决于 transport / 模型 |
| TEN | ○ RTC / graph | ○ | ◎ | ○ | ◎ | ⚠ 许可证先行 |
| Vision Agents | △ EdgeTransport | ◎ | ◎ | ◎ | ◎ | △ 需自备 edge |
| HF Speech-to-Speech | ○ 单会话媒体入口 | ◎ | ◎ | — 原生模型 | ○ tools | ◎,取决于所接模型 |
| Bolna | △ 电话媒体流 | ○ WS / telephony | ◎ | △ | ○ | ○ orchestration |
| FastRTC | △ 应用级 RTC | ◎ | ○ | ○ | △ | ○ |
| Vocode | △ 电话 / Zoom | ○ | ◎ | △ | ○ | ○,但维护风险 |
| OpenAI Agents SDK | — | ○ 依赖 OpenAI | ◎ VoicePipeline | ◎ 依赖 OpenAI | ◎ | ⚠ Realtime 不可自托管 |
| HA Assist + Wyoming | ○ 家庭卫星 | ○ WS / TCP PCM | ◎ | — | ○ intent | ◎ |
| OpenVoiceOS | ○ 设备 / 总线 | △ | ◎ | △ 插件 | ◎ skills | ◎ |
| AIRI | △ 客户端音频 | ○ WebAudio / WS | ○ | △ Provider | ○ | ○,Provider 能力另算 |
| qwen-audio-agent | △ loopback Gateway | ◎ WS PCM | △ Provider 路径 | ◎ 接 Provider | ◎ durable Task / ACP | △ runtime 可自托管;默认模型托管 |
| Moshi | △ 示例 server | ○ | — | ◎ 原生全双工 | △ | ◎ 推理,平台需外建 |
| Ultravox | — | — | — | △ 音频→文本 | △ | ○ 推理,TTS / runtime 外建 |
3.2 交互、入口与治理
| 项目 | 轮次 / 打断 | 可听历史闭环 | 电话 | 视频 | 本地 / 硬件 | 观测与扩展 | 首要风险 |
|---|---|---|---|---|---|---|---|
| LiveKit | ◎ | ◎ | ◎ SIP | ○ | ○ | ◎ | 部署复杂度 |
| Pipecat | ◎ | △ 依赖 transport / client | ◎ 集成 | ◎ | ○ | ◎ | 组合面较宽 |
| TEN | ○ | △ | ○ | ◎ | ⚠ 许可限制 | ○ | 非标准附加许可 |
| Vision Agents | ◎ | △ | ○ Twilio / Telnyx | ◎ | △ | ◎ 指标 / OTel | 默认商业 edge |
| HF Speech-to-Speech | ○ generation fencing | △ WS truncate no-op | — | — | ○ 机器人 | ○ | 核心兼容而非完整兼容 |
| Bolna | ○ | △ | ◎ | — | — | ○ | 托管 / 开源边界 |
| FastRTC | ○ | △ | ○ | ◎ | △ | △ | 原型到平台的鸿沟 |
| Vocode | ○ | △ | ◎ | — | — | △ | 维护停滞 |
| OpenAI Agents SDK | ○ | ○ 由服务处理 | ○ SIP 路径依赖服务 | — | — | ○ | Provider 锁定 |
| HA Assist + Wyoming | ○ 固定 pipeline | — | — | — | ◎ | ○ | 非开放式长对话 runtime |
| OpenVoiceOS | ○ | △ | △ | — | ◎ | ○ | 生态一致性 |
| AIRI | ○ 播放级取消 | △ 服务历史另管 | △ Discord 音频 | △ 头像 / 游戏画面 | ◎ Desktop | ○ | 产品耦合较强 |
| qwen-audio-agent | ○ cancel / clear / generation fence | △ 未见 item 精确 truncate | — | — | ◎ 本地 Web / TUI / Desktop | ○ 任务恢复 / 脱敏日志 | 单机 PCM 中继与远程生产边界 |
| Moshi | ◎ 模型内双讲 | △ 应用侧仍需 playout ledger | — | — | △ | △ | 工具与生产控制面缺失 |
| Ultravox | △ 输入侧 | — | — | — | △ | △ | 无音频输出 |
3.3 为什么不提供一个加权总分
总分会奖励“职责范围大”,惩罚“把一件事做深”。Moshi 如果在电话、SIP、RAG 和客户端 SDK 上得零分,不代表它作为原生全双工模型不优秀;AIRI 在 SFU 上得零分,也不影响它作为数字伙伴产品参考。正确做法是先决定自己需要承担哪几层,再在同一层内比较成熟度、延迟、运维和开放边界。
四、决定体验上限的技术:自然打断与可听历史
实时语音的“打断”至少包含五步:
检测用户开始说话
  → 判定是真实插话而非回声 / 噪声
  → 取消模型 / TTS 的旧 generation
  → 清空服务端和客户端尚未播放的旧音频
  → 按真实播放位置投影对话历史,再开始新轮次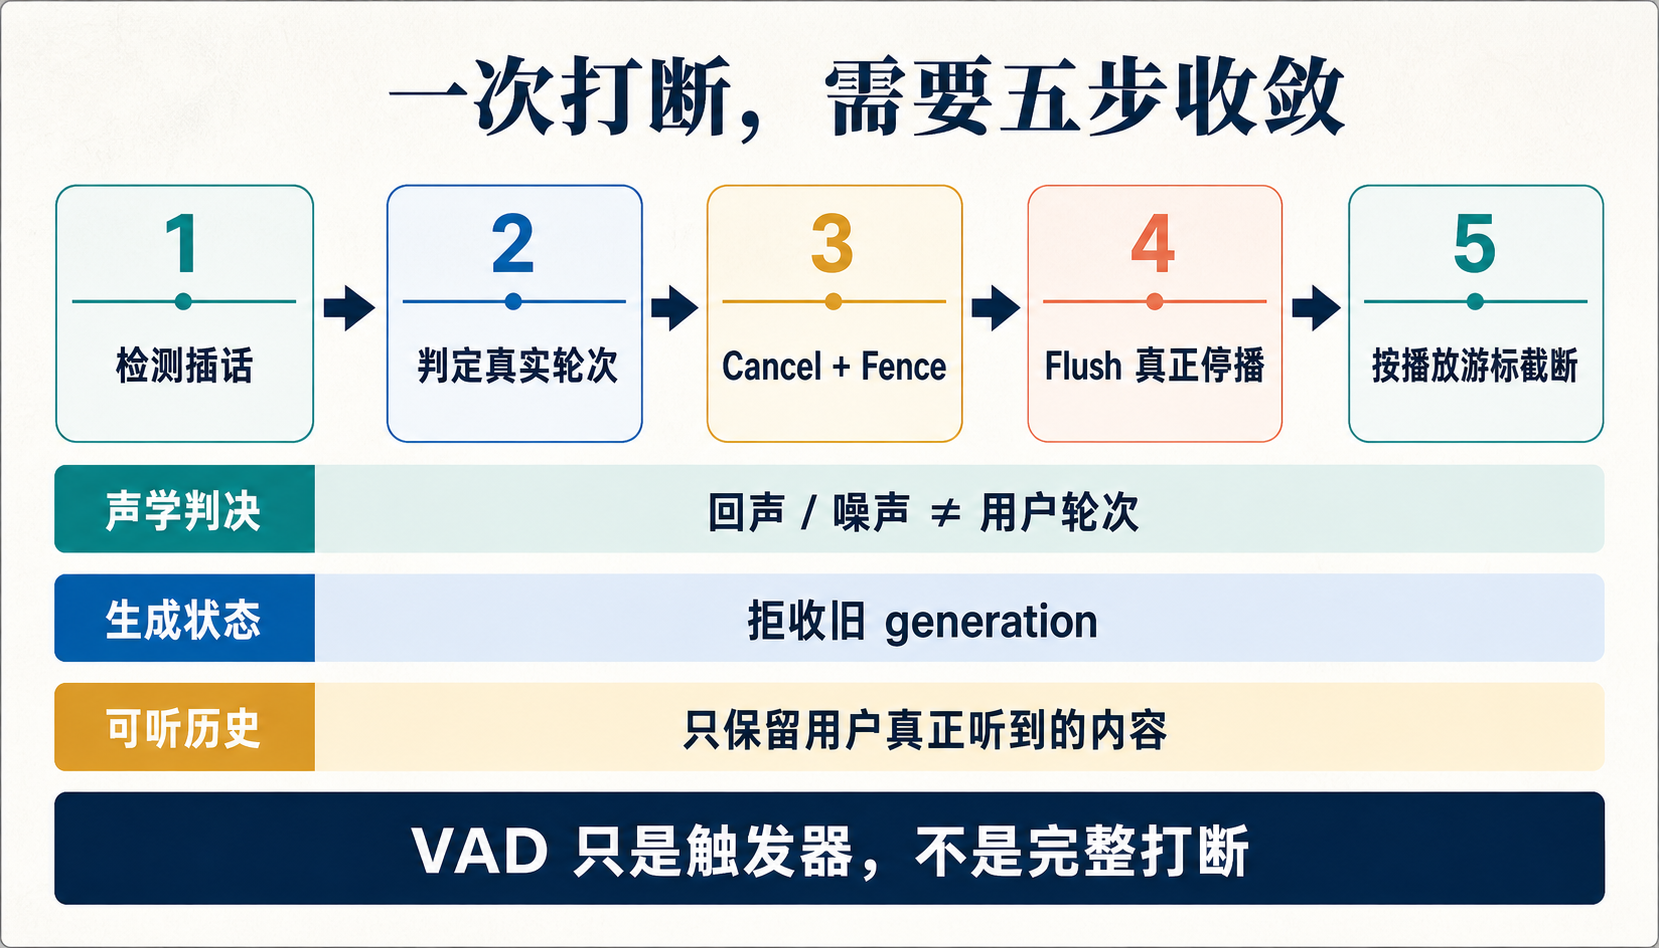
只做第一步 VAD,会出现三个经典故障:助手仍在扬声器里说话;取消前已经排队的旧音频在网络恢复后“复活”;模型记住了用户实际上没有听到的后半句。
| 项目 | 已实现的强项 | 仍需要应用补齐的部分 |
|---|---|---|
| LiveKit | AgentSession / AgentActivity 协调 interruption、generation cancel、音频 flush、播放位置与对话截断 | 客户端真实扬声器位置与服务端 AudioSource 位置仍可能有误差,严苛场景需客户端 playout acknowledgement |
| Pipecat | Turn management、VAD / Smart Turn、Frame cancellation 与 transport 抽象完整 | 可听历史的最终权威取决于具体客户端和 transport,不是 Pipeline 单独能证明 |
| HF Speech-to-Speech | CancelScope 以 generation counter 标记输出;取消后丢弃旧 generation 的音频和事件,解决迟到输出复活 | WebSocket conversation.item.truncate 当前接受但 no-op;能丢弃生成,不等于按客户端真实播放游标重写已听历史 |
| Vision Agents | Realtime flow 会调用 LLM interrupt、清音频输出并 flush;cascade flow 取消 LLM turn、清 LLM / TTS / audio queue 并 interrupt TTS | 仍需具体 Edge / client 报告真实停播位置,才能形成严格的 audible-history ledger |
| AIRI | SpeechPipeline、PlaybackManager、AbortController、queue / interrupt / replace 策略和 sequence ordering 把产品侧播控做得很认真 | 后端模型历史与本地真实播放进度之间的统一投影仍是集成责任 |
| qwen-audio-agent | response.cancel、playback.clear、客户端播放回执和 generation suppression 协同,能停止旧声音并隔离迟到展示 | 全仓未见 conversation.item.truncate 或等价的 played-sample→assistant-item 映射;模型历史可能保留用户未听内容 |
| Moshi | 模型天生同时接收用户和生成助手音频,双讲不是“先 STT 再 TTS”的外挂状态 | 网络队列、客户端 flush、工具副作用和持久对话历史仍在模型外 |
HF 的取消实现尤其值得复用:CancelScope 维护 generation 与 discard 状态,旧输出即使晚到也会被识别为 stale。它解决的是“迟到旧音频隔离”;若要达到 GPT Live / LiveKit 一类自然打断,还要再加入客户端播放游标和 conversation projection。
五、开源边界:为什么不能只看 LICENSE
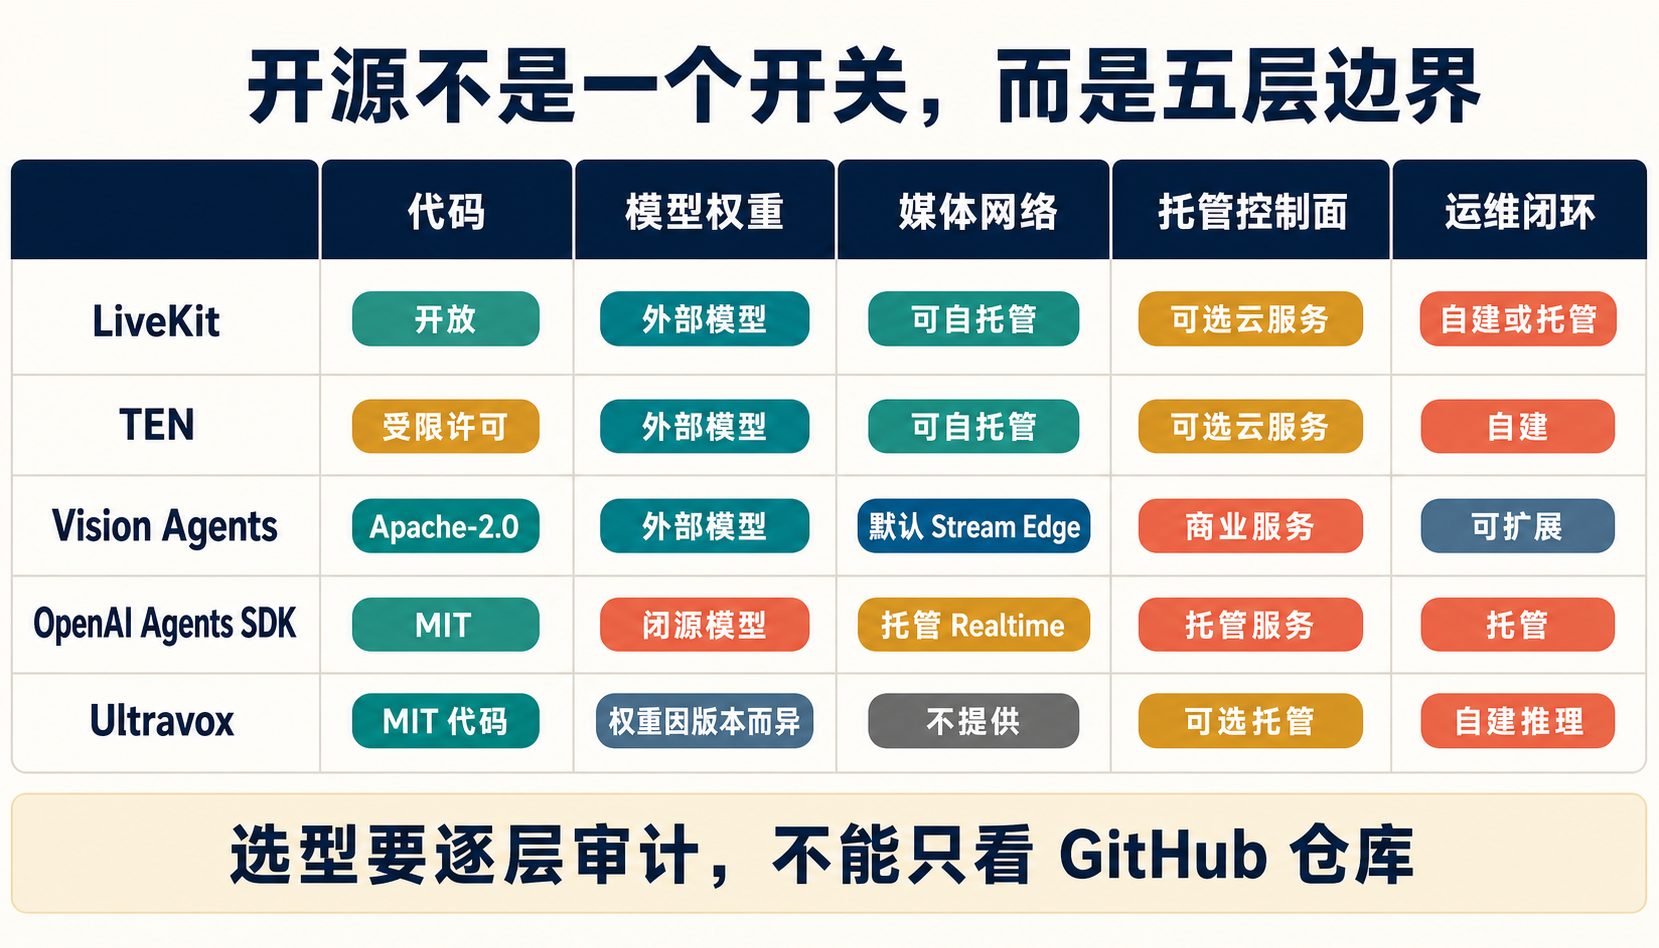
| 项目 | 代码 | 模型权重 | 媒体网络 | 托管控制面 | 实际含义 |
|---|---|---|---|---|---|
| LiveKit | Apache-2.0 | 外部 Provider / 自选 | Server / SIP 可自托管 | Cloud 可选 | 最完整的开源媒体平台路径之一,但 Cloud Inference、Insights、增强降噪另算 |
| Pipecat | BSD-2-Clause | 外部 Provider / 自选 | 通过 Daily、LiveKit、SmallWebRTC 等 transport | 无强制控制面 | 框架开放,最终系统开放度取决于组合 |
| TEN | 有源码 | 外部 Provider / 自选 | 可部署 | Cloud 可选 | 附加条款限制终端托管与竞争用途,企业采用前必须审计 |
| Vision Agents | Apache-2.0 | 外部 Provider / 自选 | 默认 Stream Edge;可实现其他 EdgeTransport | Stream 商业服务 | Agent runtime 开放,不等于默认媒体边缘网络可自托管 |
| OpenAI Agents SDK | MIT | OpenAI 模型闭源 | Realtime 托管 | OpenAI 托管 | 开放的是 SDK,不是完整运行栈 |
| HF Speech-to-Speech | Apache-2.0 | 每个 STT / LLM / TTS 单独审计 | 自带 WS / WebRTC server | 无必需托管面 | 最接近“协议兼容 + 全本地级联”的组合,但模型许可证仍可能不同 |
| Moshi | MIT / Apache 代码 | CC-BY 4.0 权重 | 示例服务 | 无必需托管面 | 模型 / 推理开放,产品平台职责仍空缺 |
| Ultravox | MIT 代码 | 依具体模型版本与 backbone | 不提供 | 托管服务可选 | 必须逐个 model card 审计,且仍需 TTS 与 Agent runtime |
| AIRI | MIT | 外部或本地 Provider | 客户端 / 自选后端 | 无强制面 | 产品壳可自托管,但上游模型、TTS 和第三方连接分别决定数据边界 |
| qwen-audio-agent | Apache-2.0 | 默认 Qwen / DashScope Realtime 另算;可接本地 S2S | loopback WebSocket Gateway,无必需云媒体面 | 无必需托管控制面 | 本地 runtime 可自托管;默认模型和远程生产媒体能力并不随仓库开放 |
对“全本地”的严格定义应是:音频不离开自有网络;STT / LLM / TTS 或原生模型都在自有算力;WebRTC / TURN / SIP 和会话状态自管;没有必需的托管控制面;依赖许可证允许目标部署;日志和录音策略也由自己控制。只把模型下载到本地,不满足这个定义。
六、15 个项目逐项解剖
6.1 LiveKit:最完整的媒体基础设施 + Agent runtime
LiveKit 的优势不是 Provider 数量,而是贯通客户端 SDK、WebRTC SFU、Room / Participant / Track、SIP、Agent dispatch、Worker / Job 和 AgentSession。它既可以跑 STT→LLM→TTS,也可以桥接 OpenAI / Gemini 一类 Realtime model;同一套 Room 还能承载多参与者、数据通道和视频。对希望自建“类 GPT Live 平台”而不是单一 Demo 的团队,它是最平衡的起点。
代价是系统更厚:SFU、TURN、Redis、区域共置、Agent Worker、模型 Provider 和观测都要被运维。完全自托管时不能把 LiveKit Cloud 的全球网络、Inference、Insights 或增强降噪默认算进来。详细源码链见 [LiveKit 专题报告](/reports/20260823_LiveKit 实时语音 Agent 端到端实现解剖:从 WebRTC SFU 到 AgentSession/)。
6.2 Pipecat:最清晰的 provider-neutral 实时管线
Pipecat 把音频、文本、事件、控制信号和指标都表示为 frame,再由 processor 组成 pipeline。这种设计使 transport、VAD、turn detector、STT、LLM、TTS、原生 S2S、MCP 与观测可以独立替换,也适合在同一产品中实验多条模型路线。对于已有媒体入口、希望保持模型和供应商可替换性的团队,Pipecat 比一体化平台更灵活。Pipecat 固定源码
它的边界也来自这种中立性:Pipecat 不是 SFU,最终的 WebRTC 质量、SIP 能力、客户端播放确认和多区域媒体网络依赖所接 transport。使用它时应主动定义 Session Actor、Playout Ledger、工具权限和部署拓扑,不能把“pipeline 跑通”误认为产品闭环完成。
6.3 TEN Framework:强大的实时扩展图,伴随明确许可风险
TEN 用 extension graph 连接 RTC、模型和多模态组件,适合复杂实时图和跨语言扩展;从能力面看,它覆盖语音、视频、Agent、工具与 Provider 集成,是很有竞争力的 runtime 设计参考。TEN 固定源码
但许可证不是小字问题:附加条件直接影响终端设备部署和竞争性产品。若目标是商业产品、SDK、硬件或平台,必须把它当作架构参考与候选依赖分别评估;在法务确认前,不应把它列为“标准 Apache-2.0,可无条件自托管”。
6.4 Vision Agents:语音 Agent 向实时音视频 Agent 的自然延伸
Vision Agents 的核心不是“多接一个摄像头”,而是让 Agent 同时管理 audio / video tracks、参与者、turn detector、视频 processors、Realtime / Cascade inference flow、MCP、RAG、memory、OpenTelemetry、Prometheus、HTTP server 和 Redis session。其 Agent 根据模型类型选择实时流或转写级联流;被打断时,实时流会 interrupt LLM 并 flush 输出,级联流会联动取消 LLM、TTS 与音频队列。Vision Agents 固定源码
最重要的架构点是 EdgeTransport:媒体网络被抽象成可替换边缘层,但默认的 Stream Edge 和客户端生态属于商业服务。若要求完全自托管,需要实现并维护自己的 edge adapter;因此它更像“开放的多模态 Agent runtime + 默认商业媒体网络”,而不是 LiveKit Server 的同类 SFU。
6.5 Hugging Face Speech-to-Speech:最接近开源 Realtime 兼容后端
该项目把 VAD、STT、LLM、TTS 放在独立线程,通过队列组成低延迟 server,并暴露 OpenAI Realtime GA 的核心 client / server events。WebRTC 通过 /v1/realtime/calls 接收 SDP,用 RTP 承载音频、oai-events data channel 承载事件;WebSocket 也可直接接入。官方仓库还固定了与 OpenAI Agents SDK 的兼容测试路径。协议说明
它的价值不是“又一个 STT→LLM→TTS 示例”,而是把客户端协议稳定性与后端模型可替换性连接起来:客户端可以面向 Realtime event surface 开发,后端则换成本地 Parakeet、vLLM / llama.cpp、Qwen3-TTS 等组件。限制是它只承诺核心事件面,WS truncate 仍为 no-op;生产环境还需要鉴权、配额、多租户 Session、GPU 调度、持久会话、电话入口和跨层 trace。
6.6 Bolna:电话优先的级联语音 orchestration
Bolna 把电话 Provider、流式输入输出、STT、LLM、TTS 和 interruption 放在主路径,适合呼叫中心、外呼、预约和客服等电话场景。相比通用框架,它对 telephony 的默认假设更贴近业务;相比闭源 SaaS,开源 orchestration 允许团队掌握 Prompt、Provider 和部分数据路径。Bolna 固定源码
采用时要拆开看开源仓库与 Hosted APIs / UI,并验证录音、PII、DNC、重试、呼叫状态、双向打断和 Provider failover。若同时需要 Web / App、多方房间和视频,Pipecat 或 LiveKit 更适合作为统一底座。
6.7 FastRTC:把实时音视频原型压缩成一个 Python handler
FastRTC 的强项是开发速度:Python 函数可以快速变成 WebRTC / WebSocket 实时音视频应用,并带有 VAD / turn-taking、Gradio UI、FastAPI 挂载和电话接入路径。它适合算法 Demo、内部实验、教学和快速验证端到端延迟。FastRTC 固定源码
其抽象目标不是多租户生产平台。进入产品阶段后,还要补 Session 隔离、工具权限、幂等、队列治理、旧音频 fencing、跨区域媒体、容量调度、审计和故障恢复。最合理的定位是“最短 PoC 路径”,而不是“最后一套架构”。
6.8 Vocode:重要的历史参考,不宜作为新项目默认起点
Vocode 较早把流式 STT、LLM、TTS、电话和 Zoom 组织为模块化语音 Agent 库,对理解早期 cascade voice agent 很有价值。Vocode 固定源码
但仓库公开寻求维护者,固定快照前最后 push 停留在 2024-11。对新项目,依赖新 Provider、当前 Realtime 模型、最新 WebRTC / telephony 生态和长期安全维护时,应优先选择 LiveKit、Pipecat、Bolna 或 HF Speech-to-Speech;Vocode 更适合维护既有系统或迁移时参考。
6.9 OpenAI Agents SDK:开放 SDK,闭源 Realtime 服务
OpenAI Agents SDK 提供两条语音路径:RealtimeAgent 直接使用 OpenAI Realtime,会得到最贴近 OpenAI 当前能力的低延迟原生交互;VoicePipeline 则走 audio→text→agent workflow→speech 的级联路径。工具、handoff、guardrails 和 tracing 能与文本 Agent 生态复用。OpenAI Agents Python 固定源码
它适合已经选择 OpenAI 的团队,但开源范围只能写成“SDK”:模型权重、Realtime media service、VAD / turn internals 和托管控制面不可自托管。需要 Provider-neutral 或本地替代时,可以让客户端保持 OpenAI Realtime 核心协议,后端试接 HF Speech-to-Speech,但必须做兼容矩阵而非假定逐项等价。
6.10 Home Assistant Assist + Wyoming:最成熟的本地家庭语音分解
Home Assistant 的 voice pipeline 明确分为 wake word、STT、intent、TTS,并通过事件暴露每阶段状态;Wyoming 则用基于 TCP 的 JSONL 事件与 PCM 音频把卫星、Whisper、Piper、openWakeWord 等服务连接起来。它们共同证明:低功耗终端不必承载完整大模型,局域网内可用稳定协议连接独立语音服务。Assist pipelines Wyoming 固定源码
这套架构非常适合家庭、树莓派、卫星麦克风和本地隐私,但其轮次通常是命令式 pipeline,不等于 GPT Live 式开放域全双工长对话。若叠加 LLM,应保留 Home Assistant 作为设备权限与真实状态权威,而不是让模型直接控制设备。
6.11 OpenVoiceOS:本地语音助手的 OS / skills 生态
OpenVoiceOS 继承并扩展了模块化语音助手思路,以 message bus、skills、persona、插件和面向嵌入式设备的发行方式组织系统。它适合自定义唤醒词、离线服务、硬件产品和长期运行的本地助手。OVOS 固定源码
它的核心抽象是“语音助手操作系统”,不是浏览器优先的 WebRTC Agent 平台。选择它意味着收益来自设备和 skills 生态;若目标是超低延迟全双工、多方视频或云端弹性 Agent,还要引入专门媒体与 realtime runtime。
6.12 AIRI:研究完整数字伙伴产品,而不是媒体后端
AIRI 以 Web / macOS / Windows 为产品表面,组合 WebGPU、WebAudio、Web Workers、WASM、WebSocket、本地 / 云端语音识别、Talking detection、多 Provider TTS、VRM / Live2D、记忆和游戏连接。它最值得看的不是功能列表,而是产品侧的实时状态治理:共享 SpeechPipeline 支持 streaming、文本分块、TTS 并发和 queue / interrupt / replace;PlaybackManager 用队列、AbortController、顺序控制和 interruption events 管理真实播放;chat runtime 用 session generation guard 防止旧会话输出污染新会话。AIRI 固定源码 SpeechPipeline
这些实现让 AIRI 成为“如何把语音、形象、记忆与互动做成产品”的优秀参考。但它不提供通用 SFU、电话控制面、跨区域 Worker 调度或 OpenAI Realtime 兼容 server。最合理的复用方式是把 AIRI 当客户端 / 产品壳,后端连接自己的 LiveKit、Pipecat 或 Realtime-compatible service。
6.13 Moshi:最接近开放原生全双工语音模型
Moshi 与 Mimi codec 让模型同时处理用户和助手两条音频流,目标是低延迟、可双讲的原生语音交互;仓库提供 PyTorch、MLX、Rust 和 Web demo / server 路径。它减少了 cascade 中 STT 文本瓶颈、TTS 拼接与轮次切换的人工边界,是研究“模型内部如何做实时对话”的首选开放基线。Moshi 固定源码
但模型全双工不等于产品全双工。客户端 AEC、网络抖动、取消旧包、播放游标、工具安全、记忆、身份、容量调度和多租户治理仍在模型外。生产设计应把 Moshi 放进一个 Realtime Model Adapter,而不是让模型 server 同时承担所有业务职责。
6.14 Ultravox:优秀的音频理解模型,不是完整语音 Agent
Ultravox 将音频特征投影到开放语言模型,使模型直接理解韵律、语气和非纯文本信息并流式输出文本。它适合语音理解、复杂音频问答和想避免独立 STT 的场景。Ultravox 固定源码
其关键边界是没有原生音频输出:要形成语音 Agent,仍需 TTS、播放和 interruption runtime。权重许可还会随具体 Ultravox 版本和底座模型变化,不能用代码仓库的 MIT 许可证替代 model card 审计。
6.15 qwen-audio-agent:将 Realtime 前台与持久后台 Agent 分成双速 runtime
qwen-audio-agent 的核心不是提供新的媒体网络或开放权重语音模型,而是把个人桌面语音 Agent 中长期被应用层忽略的控制面做成了运行时:Web / TUI / Desktop 客户端的 16 kHz PCM 通过 loopback WebSocket 进入本地 Gateway,Gateway 连接 Realtime Provider,管理 active voice owner、播放生命周期、打断、权限、记忆和通知;需要文件、终端、搜索或长推理的工作则从前台工具 spawn_thinking 进入 durable Task,经 owner lane、BackendPort 与持久 ACP Session 继续执行。任务终态由 notification claim lease 协调,并只在安全双工窗口回写为语音播报。详见 [Qwen Audio Agent 专题报告](/reports/20260828_Qwen Audio Agent 端到端实现解剖:从本地音频 Gateway 到异步后台 Agent/)。
这个分层使它特别适合“继续交谈,同时让既有编码 Agent 跑测试、搜索或改代码”的单用户桌面场景;也为 LiveKit / Pipecat 一类通用 runtime 补上了可借鉴的任务恢复与结果交付语义。其边界同样清晰:Base64 PCM 的双 WebSocket 中继不是 WebRTC jitter buffer、Opus、TURN、SIP、Room/SFU 或全球媒体平面;固定源码虽实现 response.cancel、playback.clear 与 generation fence,却未发现按真实播放位置截断远端 conversation item 的证据。因此它应被当作本地产品控制面与后台 Agent runtime 参考,而不是生产媒体平台或完全本地 Qwen Audio 推理栈。
七、按场景选型与组合架构
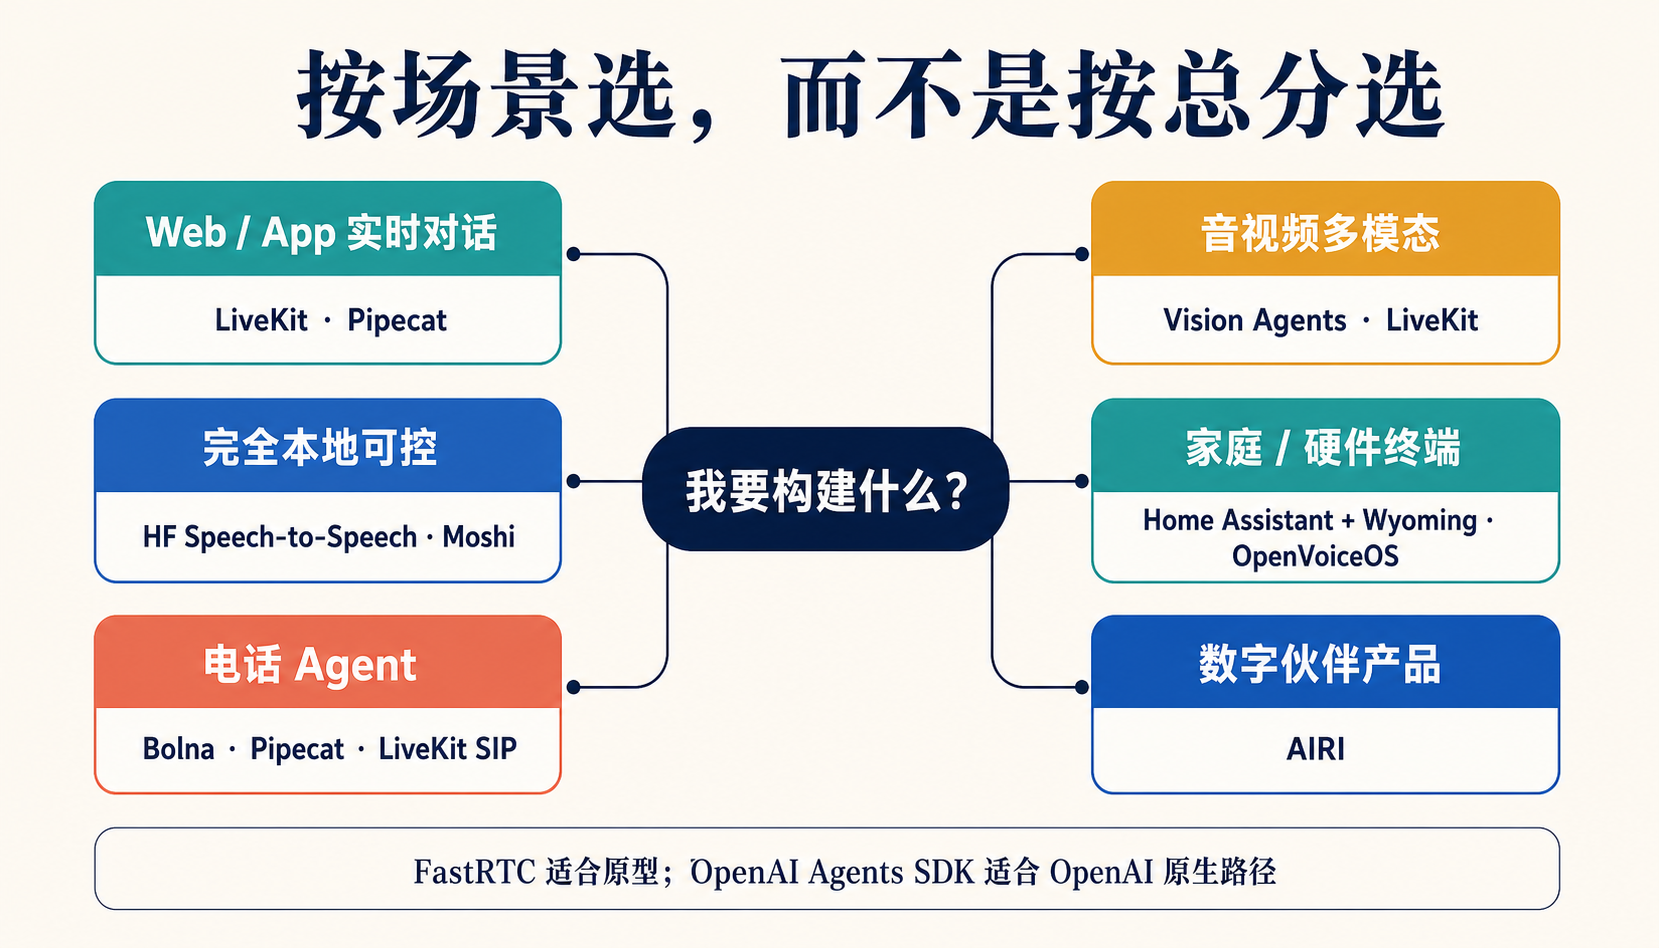
7.1 类 GPT Live 的 Web / App 产品
推荐组合 A:LiveKit Server + LiveKit Agents / Pipecat + 任意 Realtime Model
适合需要 Web / iOS / Android、SIP、多参与者、模型切换、工具和生产调度的团队。媒体与 Agent 可分别扩展;代价是多一个 SFU / Agent hop 和更厚的运维面。
推荐组合 B:客户端直连 OpenAI Realtime + 自有 sideband / Capability Gateway
适合单用户、OpenAI-first、追求最短媒体路径的产品。它不是开源全栈方案,详细边界见 [OpenAI Realtime 专题报告](/reports/20260823_OpenAI Realtime API 端到端实现逆向分析:从客户端音频到实时语音模型/)。
推荐组合 C:qwen-audio-agent 式本地 Gateway + Realtime Provider + 既有编码 Agent
适合单用户桌面工作流:用一个本机权威进程收拢凭据、语音 Session、权限、通知与 durable Task,再以 ACP/adapter 接入既有 Agent。它换来的是任务恢复与本地控制,不是更好的公网媒体;移动端、SIP、多方与弱网场景仍应把媒体移到 WebRTC/SIP/SFU。
7.2 完全本地、协议稳定的语音系统
推荐:HF Speech-to-Speech + 本地 STT / LLM / TTS + 自有 Session / Auth / Observability。 客户端面向 Realtime 核心事件开发,后端组件可逐步替换;先补齐 truncate / playout ledger、配额、多租户和 GPU 调度。若研究目标是原生模型能力,可并行建立 Moshi adapter 做 A/B,而不是一开始押注单一路线。
7.3 电话 Agent
- 单一电话业务、希望快速控制 Provider:Bolna。
- 多 Provider、复杂工具流、还要支持 Web:Pipecat。
- 需要统一 Web / App / SIP / 多方媒体和弹性 Agent:LiveKit SIP + Agents。
电话场景必须额外验证号码合规、录音告知、PII、DTMF、transfer、voicemail、重拨幂等和运营商网络延迟;这些不能由 LLM benchmark 代替。
7.4 音视频实时 Agent
Vision Agents 适合从一开始就需要 camera tracks、视频处理器、VLM、说话人过滤和音视频指标的产品。若希望自托管媒体,需先做自定义 EdgeTransport 的可行性 PoC;若团队已经采用 LiveKit,也可以用其 Room / video tracks 构建自己的 vision processor 层,但这属于架构组合判断,不是现成的官方无缝连接器承诺。
7.5 家庭、树莓派与嵌入式设备
Home Assistant + Wyoming 最适合“设备控制是真实业务”的家庭系统;OpenVoiceOS 适合更通用的本地 skills / persona 设备;AIRI 适合带屏幕、形象和陪伴体验的桌面终端。共同原则是:设备状态和权限留在本地可信控制面,语音模型只表达意图。
7.6 数字伙伴与虚拟角色
以 AIRI 为产品壳,把头像、情绪、记忆、TTS、游戏输入和客户端播放状态保留在体验层;后端根据部署目标选择 LiveKit、Pipecat、HF Speech-to-Speech 或托管 Realtime。不要为了复用 AIRI 的 UI,顺带把其当前 Provider 和会话假设固化成不可替换架构。
八、如果由我们实现:推荐的可组合架构
Web / Mobile / Desktop / Phone / Device
  ├─ Audio Frontend: AEC · NS · AGC · device routing · playout ledger
  └─ Client Protocol: WebRTC / Realtime events / SIP
                  ↓
Media Fabric: LiveKit Server,或自有 WebRTC gateway
                  ↓
Session Actor: turn state · generation id · cancel / fence · recovery
                  ↓
Agent Runtime: LiveKit Agents / Pipecat / Vision Agents / 自研
  ├─ Model Adapter A: STT → LLM → TTS
  ├─ Model Adapter B: HF Speech-to-Speech compatible backend
  ├─ Model Adapter C: OpenAI / Gemini Realtime
  └─ Model Adapter D: Moshi / Ultravox + TTS
                  ↓
Capability Gateway: auth · policy · confirmation · idempotency · audit
                  ↓
Business Systems / Memory / Background Agents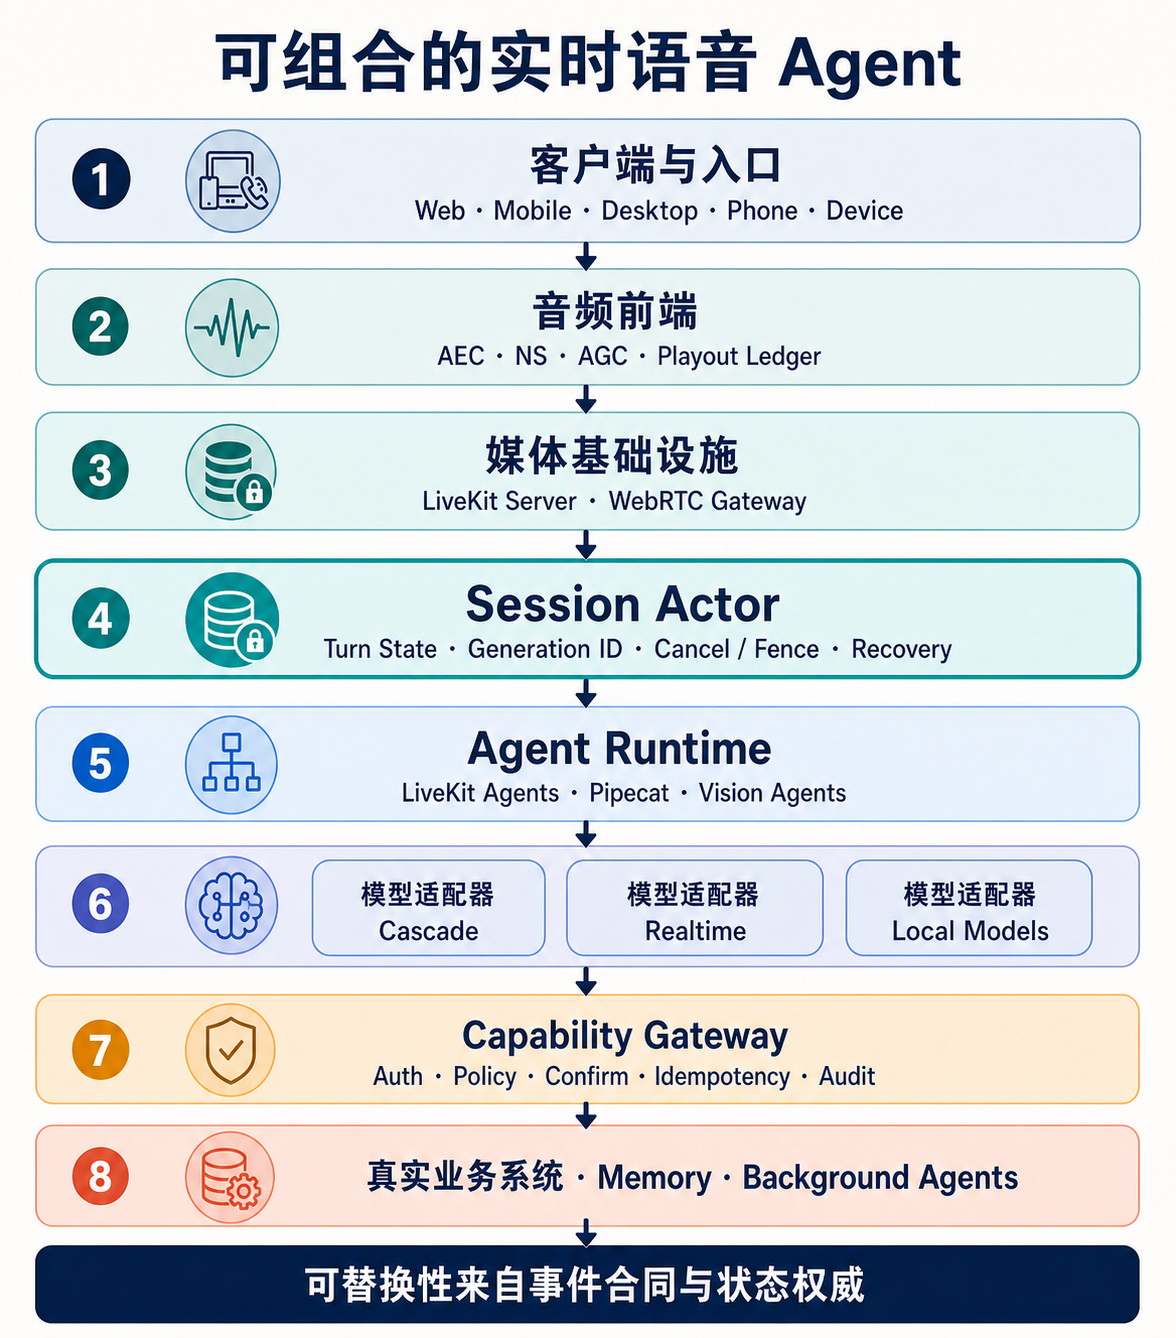
这里有五个不应交给单一第三方库隐式决定的自有契约:
- Session Actor:每个会话只有一个轮次权威,generation id 贯穿模型、TTS、媒体队列和客户端。
- Playout Ledger:记录客户端真正播放到哪里;模型生成全文只进入审计,不直接等同对话历史。
- Model Adapter:把 cascade、native Realtime 和开放模型收敛到统一的 audio / transcript / tool / interruption 事件。
- Capability Gateway:工具调用只是意图;鉴权、确认、幂等、审计和真实结果由自有后端负责。
- Cross-layer Trace:同一个
session_id / turn_id / response_id / generation_id / tool_call_id贯穿客户端、媒体、模型和业务动作。
这套架构允许先用托管 Realtime 获得体验,再把模型路径替换为 HF Speech-to-Speech 或 Moshi;也允许先用 FastRTC 验证算法,再把媒体和会话迁到 LiveKit / Pipecat。真正的可替换性来自自有事件契约与状态权威,而不是 Provider 数量。
九、PoC 与生产验收清单
9.1 不要只测“能不能聊天”
| 类别 | 必测场景 | 建议观测 |
|---|---|---|
| 客户端声学 | 外放双讲、耳机、蓝牙切换、远场、噪声、多个浏览器 / 手机型号 | 回声残留、false interrupt、设备切换中断、采集丢帧 |
| 首音延迟 | 短问、长问、工具前后、不同地域、冷启动 | speech-end→first-audio、各阶段 P50 / P95、队列等待 |
| 打断 | 助手首音前、播报中、TTS 尾部、连续两次插话、弱网恢复 | user-start→output-silence、cancel 后 stale audio、历史投影误差 |
| 传输 | 1%–10% 丢包、抖动、切网、ICE restart、WS reconnect | concealment、重连时间、重复 / 乱序事件、会话恢复 |
| 工具 | 超时、重复调用、需要确认、权限不足、部分成功 | 幂等命中、错误分类、真实结果回填、审计链 |
| 容量 | 并发 Session、GPU 饱和、TTS 慢 Provider、Worker drain | queue depth、RTF、CPU / GPU、单会话隔离、扩缩容 |
| 隐私 | 录音开关、PII、日志采样、数据驻留、删除 | 数据流向、保留期、访问审计、第三方出站 |
9.2 候选项目的同场景 Bake-off
不要分别跑各项目自带 Demo。建立同一个测试应用、相同麦克风 / 扬声器、相同 Prompt、相同工具、相同地域和相同模型,替换 runtime / transport 后比较:
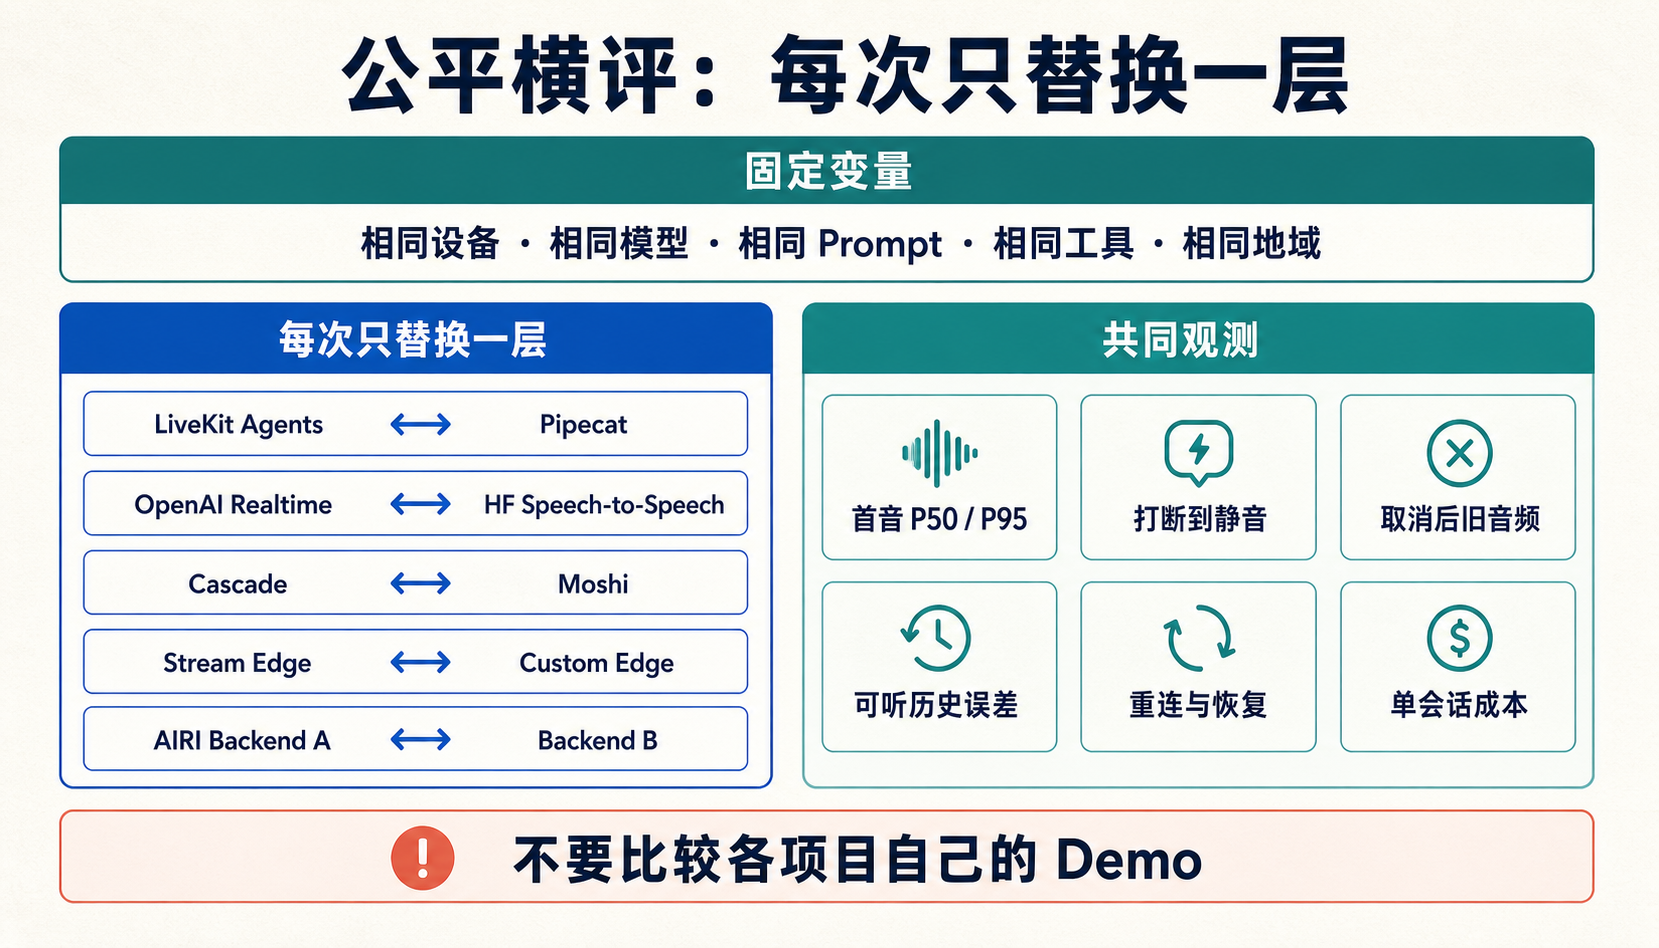
- LiveKit Agents vs Pipecat:媒体 hop、打断闭环、开发复杂度、可观测和多入口。
- OpenAI Realtime vs HF Speech-to-Speech:协议兼容、首音、打断、工具事件、成本与本地数据边界。
- Cascade vs Moshi:语义质量、韵律、双讲、品牌音色、工具可控性与 GPU 成本。
- Vision Agents 默认 edge vs 自定义 edge:音视频同步、视频采样、多人说话与自托管成本。
- AIRI 客户端接不同后端:播放取消、会话切换、记忆一致性和产品耦合。
- qwen-audio-agent 式 Gateway vs 直连 Realtime + 自有 sideband:首音与打断代价、后台任务恢复、播放—历史投影、权限确认和本机故障域。
9.3 一票否决项
- 许可证不允许目标部署或商业用途。
- 无法在打断后阻止旧音频复活。
- 工具没有鉴权、幂等和审计边界。
- 无法解释音频、transcript、模型与业务事件的因果关系。
- 关键客户端或电话入口只能依赖不可接受的数据出境路径。
- 项目无维护者、无安全更新路径,团队又没有能力 fork 自持。
十、最终结论
开源语音 Agent 生态已经不是“找一个 STT、一个 LLM、一个 TTS”这么简单,而是出现了五类成熟分工:媒体平台、Agent runtime、协议兼容后端、原生音频模型和产品 / 设备外壳。最稳健的工程策略不是押注单一仓库,而是先确定状态权威与事件契约,再按层组合:
- 用 LiveKit 解决生产媒体、多入口与 Agent 调度;
- 用 Pipecat 保持模型和 transport 可替换;
- 用 HF Speech-to-Speech 建立 OpenAI Realtime 核心协议兼容的本地级联路径;
- 用 Vision Agents 探索音视频实时 Agent;
- 用 Moshi / Ultravox 分别研究原生全双工与直接音频理解;
- 用 qwen-audio-agent 学习本地 Gateway、双速 Task/Session、后台 Agent 恢复与结果播报;
- 用 Home Assistant / OpenVoiceOS / AIRI 学习设备、技能和产品体验,而不是把它们误当通用后端。
若下一步继续做专题解剖,优先级建议是:HF Speech-to-Speech → Pipecat → Vision Agents → AIRI;qwen-audio-agent 已有独立源码报告,可作为“本地语音前台 + 持久编码 Agent 后台”的控制面对照。前两者最能回答“如何做一个可替换 OpenAI Realtime 的开放后端”,后两者分别回答“如何把语音扩展到视频”和“如何把语音能力做成完整数字伙伴产品”。
Source Manifest
- 完整来源、固定 commit、许可证、关键源码路径与限制见 Source Manifest。
- 三张 ImageGen 信息图的 prompt、尺寸、SHA-256 与视觉验收见 ImageGen Manifest。
- 本报告复用了 实时语音 Agent 端到端架构、[OpenAI Realtime 专题报告](/reports/20260823_OpenAI Realtime API 端到端实现逆向分析:从客户端音频到实时语音模型/)、[LiveKit 专题报告](/reports/20260823_LiveKit 实时语音 Agent 端到端实现解剖:从 WebRTC SFU 到 AgentSession/)和 [Qwen Audio Agent 专题报告](/reports/20260828_Qwen Audio Agent 端到端实现解剖:从本地音频 Gateway 到异步后台 Agent/)中的端到端系统模型;项目横评结论重新回到各官方仓库核对,不以旧报告摘要代替原始证据。
- 原有 14 项证据快照为 2026-08-24;qwen-audio-agent 补充证据固定于 2026-08-28 commit
8565c03。活跃度、API、模型、许可证和托管边界都可能变化,正式采用前必须重新核对。 - 尚未执行真实账号集成、主观语音质量盲测、客户端设备矩阵、电话运营商 E2E、多节点故障注入和生产并发压测;因此本文是源码与架构决策报告,不是性能排行榜或供应商 SLA。